Выбор вычислительной архитектуры высокоуровневого БПЛА: техническая логика и продуктовые решения чистого FPGA против MPSoC
При проектировании бортовых вычислительных архитектур высокоуровневых БПЛА вопрос «чистый FPGA или MPSoC» является неизбежным ядром. Чистый FPGA превосходен в аппаратном параллелизме и детерминированной задержке; MPSoC интегрирует CPU, реального времени ядра и программируемую логику в один чип, балансируя гибкость ПО и аппаратное ускорение. Эти два решения не простые замены — они соответствуют принципиально разным характеристикам задач. Как техническая команда, глубоко работающая в области FPGA, компания Дуюань Электроникс на основе инженерной практики продуктовых линеек ZU19EG и VU13P раскладывает техническую логику этой задачи выбора от природы нагрузок БПЛА и предлагает референсные решения для разных сценариев.
I. Понимание гетерогенности нагрузок БПЛА
БПЛА — типичная многозадачная система реального времени, и его бортовые вычислительные требования можно грубо разделить на четыре категории.
Управление полётом реального времени — самый базовый уровень. IMU выдаёт данные с частотой выше 1 кГц; полётный контроллер должен завершить оценку ориентации, EKF-слияние, управление контуром ориентации и угловой скорости, а также обновить ESC по PWM или DShot. Цикл всей цепочки обычно в пределах 1 мс, а худший джиттер задержки должен быть строго ограничен.
ИИ автономные вычисления обрабатывают распознавание целей, визуальное избегание препятствий, SLAM и планирование пути. Эти задачи являются вычислительно ёмкими, но обычно допускают задержку в десятки миллисекунд.
Обработка целевой нагрузки нацелена на видео, съёмку, инспекцию и другие бизнес-данные, преследуя пропускную способность, а не экстремальное реальное время.
Детерминированная обработка сигналов охватывает сжатие радиолокационных импульсов, обработку сигналов РЭБ, высокоскоростные интерфейсы датчиков и синхронизацию времени. Их общая характеристика — завершение за микросекунды с чрезвычайно малым джиттером.
Эти четыре типа нагрузок предъявляют совершенно разные требования к архитектуре чипа — и в этом корень проблемы выбора.
II. Решение на чистом FPGA: граница и ценность детерминизма
2.1 Когда выбирать чистый FPGA
Ключевая ценность чистого FPGA — детерминизм. Его логические схемы работают в аппаратном параллелизме; сигнальные пути фиксированы после синтеза и трассировки, без ОС-планирования, задержки прерываний или промахов кэша. Поэтому FPGA обеспечивает наносекундный отклик с нулевым джиттером.
При обработке радиолокационных сигналов алгоритмы, такие как согласованная фильтрация, сжатие импульсов и БПФ, должны завершаться в каждом импульсном периоде — аппаратный конвейер FPGA гарантирует результат за детерминированное число тактов. РЭБ — наиболее репрезентативный высокоуровневый сценарий для чистого FPGA. Lockheed Martin в сотрудничестве с Altera завершила лётную демонстрацию приёмопередатчика РЭБ Gen12 на БПЛА группы 2 на основе Altera Agilex 9 Direct RF FPGA, добившись обнаружения, идентификации и геолокации реальных излучателей менее чем за 12 месяцев при соблюдении ограничений по размеру, весу и мощности. Agilex 9 Direct RF поддерживает прямую дискретизацию РЧ, устраняя узкое место интерфейса между отдельным РЧ-фронтом и цепочкой цифровой обработки.
Миниатюрные радиолокационные имитаторы также опираются на FPGA. Имитатор радиолокационных целей и помех P-диапазона, разработанный 27-м НИИ CETC, использует схему базовой обработки на FPGA: весь блок весит менее 6 кг, потребляет менее 130 Вт и может генерировать шумовые помехи, обманные помехи и плотные ложные цели. Для таких применений — жёстко фиксированные алгоритмы и экстремальная чувствительность к задержке — чистый FPGA почти жёсткий выбор.
2.2 Инженерная платформа решения на чистом FPGA
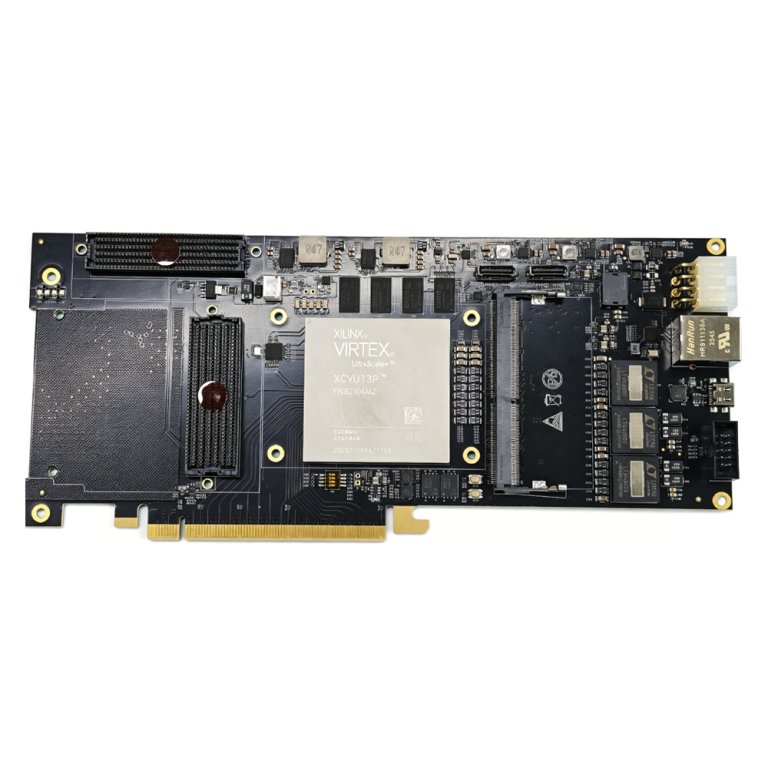
Для сценариев, требующих экстремального детерминизма, таких как обработка радиолокационных сигналов и РЭБ, Дуюань Электроникс построила PCIe-плату разработки VU13P на базе AMD Virtex UltraScale+ XCVU13P. XCVU13P предоставляет 1 728K логических ячеек, 3 456K триггеров и 12 288 DSP-блоков, изготовленных по технологии TSMC 16нм FinFET+. Плата несёт 4ГБ DDR4 (2400 Мбит/с, 64 бит), обеспечивая теоретическую полосу около 19,2 ГБ/с. Золотые контакты PCIe Gen3 x16 дают около 15,75 ГБ/с в направлении и примерно 31,5 ГБ/с двунаправленной теоретической полосы.
Интерфейс FMC+ предоставляет LA 34 пары плюс HA 24 пары дифференциальных I/O и 16 пар высокоскоростных трансиверов GTY, напрямую подключая высокоскоростные дочерние платы АЦП/ЦАП с поддержкой JESD204B и других протоколов интерфейсов — подходит для построения высококанальных систем обработки РЧ-сигналов. Масштаб логических ресурсов VU13P и плотность высокоскоростных интерфейсов делают его идеальной платформой для сжатия радиолокационных импульсов, обработки сигналов РЭБ и многоканального высокоскоростного сбора данных.
III. Решение MPSoC: гетерогенная интеграция и совместное проектирование ПО/железа
3.1 Когда выбирать MPSoC
Ключевая идея MPSoC — покрыть несколько типов задач одним чипом. На примере AMD Zynq UltraScale+ MPSoC он интегрирует 4-ядерные приложения ARM Cortex-A53, 2-ядерные процессоры реального времени Cortex-R5, программируемую логику FPGA и DSP-модули, связанные высокополосными шинами AXI.
Ключевое преимущество этой гетерогенной архитектуры — изоляция задач. Критически важное управление полётом реального времени может работать на Cortex-R5 с FreeRTOS или bare-metal программами, гарантируя детерминированные циклы управления; ИИ-вывод и сложные алгоритмы работают под Linux на Cortex-A53, пользуясь зрелой экосистемой ПО; логика FPGA обрабатывает интерфейсы датчиков, предобработку данных и аппаратное ускорение. Все три разделяют встроенную память и высокоскоростные шины, избегая узкого места межчипной коммуникации и задержки традиционных архитектур «хост плюс сопроцессор».
Количественное сравнение — Zynq UltraScale+ против NVIDIA Jetson TX2: при реальной семантической сегментации 1080p@30fps с наложенным контуром управления PID решение Zynq достигло сквозной задержки 8 мс против 22 мс у Jetson. Ключевое отличие — полоса шины AXI 32 ГБ/с между PS и PL, позволяя данным датчиков течь между CPU и FPGA с минимальными потерями.
Zynq UltraScale+ MPSoC уже имеет зрелые развёртывания в управлении полётом БПЛА. Полётный и видеоконтроллер БПЛА Enclustra использует MPSoC серии ZU для управления позицией и траекторией полёта, с датчиками и исполнительными механизмами, динамически реконфигурируемыми через логику FPGA, плюс двойной резервированный блок управления полётом. DJI Inspire 2 (выпущен в 2016) использует Zynq XC7Z045 SoC в своей системе визуализации CineCore 2.0 для реальной обработки видео 4K/60fps — раннее знаковое применение Zynq в высокоуровневых БПЛА.
3.2 Инженерная платформа решения MPSoC
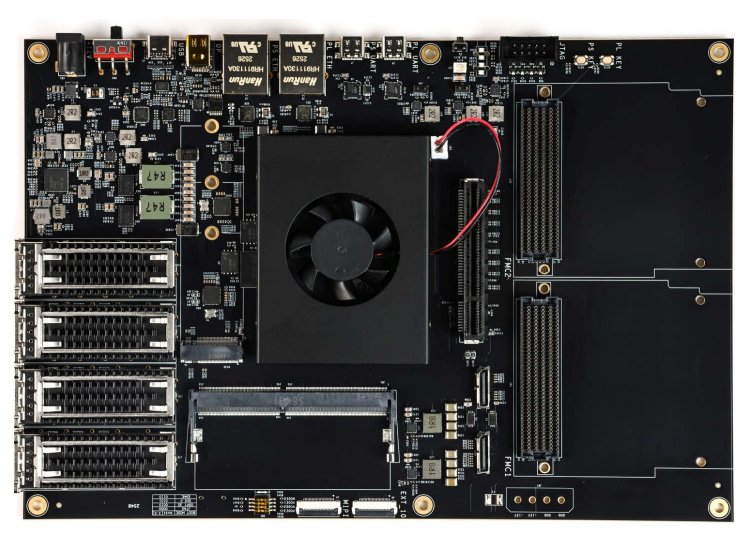
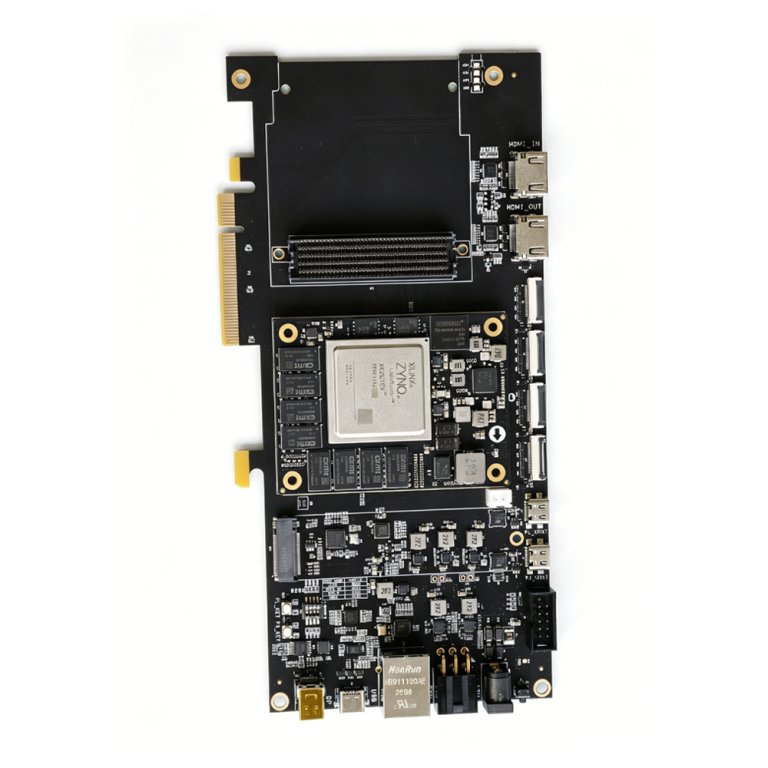
Для интегрированных задач вычислений Дуюань Электроникс построила плату разработки ZU19EG на базе Zynq UltraScale+ MPSoC XCZU19EG. ZU19EG относится к семейству Zynq UltraScale+ MPSoC EG; его определяющая черта — полная обрабатывающая система плюс крупномасштабная программируемая логика, интегрированные на одном кристалле. Сторона PS включает 4-ядерные приложения ARM Cortex-A53 (до 1,5 ГГц), 2-ядерные процессоры реального времени Cortex-R5, GPU Mali-400 и высокоскоростные периферийные интерфейсы, такие как контроллеры DDR4, PCIe Gen3, USB 3.0 и гигабитный Ethernet; сторона PL предоставляет около 1 143K логических ячеек, 1 968 DSP-блоков, 70,6 Мб RAM и многочисленные высокоскоростные трансиверы GTH/GTY.
Эта гетерогенная архитектура «совместное проектирование ПО/железа, сочетание динамического/статического» может запускать сложные ОС, такие как Linux, одновременно достигая наносекундного детерминированного отклика и аппаратного ускорения конвейера через PL. PS и PL общаются через интерфейсы AXI HP/ACP, обеспечивая архитектуру общей памяти и прямой доступ к регистрам аппаратных ускорителей без прохождения стека протоколов PCIe — типичная задержка может контролироваться в пределах 500 нс. Общее энергопотребление ZU19EG около 30 Вт, что намного ниже комбинации «плата FPGA плюс промышленный ПК», давая существенное преимущество в ограниченных по пространству и охлаждению встраиваемых средах.
IV. Четыре измерения решений о выборе
Первое — величина требований к задержке. Если задача должна завершаться за микросекунды с нулевым джиттером — например, сжатие радиолокационных импульсов, обработка сигналов РЭБ или высокоскоростное управление двигателями — чистый FPGA единственный выбор. Если временное окно в миллисекундах, реального времени ядра MPSoC плюс ускорение FPGA полностью справляются.
Второе — изменчивость алгоритмов. Сценарии, где алгоритмы, однажды определённые, редко меняются, подходят для аппаратной фиксации на чистом FPGA. Сценарии, требующие частой итерации алгоритмов и быстрой верификации — например, обновления моделей ИИ-обнаружения объектов — предпочитают гибкость ПО MPSoC.
Третье — требования к системной интеграции. Если платформа имеет строгие ограничения SWaP, однокристальное решение MPSoC значительно уменьшает площадь платы и мощность. Если требуется многоканальная прямая дискретизация РЧ или сверхвысокоскоростной сбор данных, чистый FPGA с независимым РЧ-фронтом может быть уместнее.
Четвёртое — функциональная безопасность и требования к сертификации. Авиационные БПЛА могут требовать сертификации DO-254/DO-178C. Гетерогенная архитектура MPSoC естественно поддерживает изоляцию задач — размещение критически важных функций на выделенном реального времени ядре облегчает соответствие сертификации. Проектирование функциональной безопасности чистого FPGA требует более строгого процесса аппаратной верификации.
V. Рекомендуемые модели
Направление MPSoC
AMD Zynq UltraScale+ MPSoC (серия ZU) — самый зрелый выбор MPSoC в области БПЛА. ZU5EV и ZU7EV интегрируют 4-ядерный A53, 2-ядерный R5, GPU Mali-400, видеокодеки H.264/H.265 и логику FPGA на одной плате — подходят как интегрированная платформа задач вычислений высокоуровневых БПЛА. ZU19EG предоставляет более высокую плотность логики и DSP-ресурсы, подходя для одновременной обработки управления полётом, ИИ-вывода и высокоскоростных интерфейсов датчиков. ZU3EG лучше подходит к чувствительным к мощности и размеру лёгким решениям и использовался в исследованиях как бортовой компьютер БПЛА с внутренней навигацией.
AMD Versal AI Edge Gen 2 (2VE3858/2VM3858) представляет следующее поколение эволюции. Он интегрирует приложения Arm Cortex-A78AE, процессоры реального времени Cortex-R52, GPU Mali-G78AE, логику FPGA и ускоритель ИИ-вывода (AIE-ML v2), обеспечивая свыше 200k DMIPs общего счёта и 2× производительность ИИ-вывода. New Wave Design запустила модуль V3211 SOM на основе этого чипа для БПЛА, барражирующих боеприпасов и носимых РЭБ-применений — его ключевая ценность — однокристальный интеллект: предобработка, ИИ-вывод и постобработка завершаются в одном чипе, уменьшая зависимость от многокристальных решений.
Microchip PolarFire SoC FPGA имеет уникальные преимущества в низком энергопотреблении и детерминизме. Его детерминированная архитектура обеспечивает критичное реального времени выполнение, выдавая 6500 CoreMark производительности при всего около 3 Вт — подходит для чувствительных к мощности высокоуровневых БПЛА. Встроенные модули криптоускорения и принципы Trusted Hardware также подходят для сценариев со строгими требованиями к целостности прошивки и безопасности данных.
Направление чистого FPGA
Серия Altera Agilex 9 Direct RF — флагманский выбор для РЭБ и радиолокационных применений. Устройства, такие как AGRW039, поддерживают прямую дискретизацию РЧ до 64 Гспс, интегрируя высокоскоростные АЦП/ЦАП и логику FPGA и устраняя отдельный РЧ-фронт. Программа SWIFT от Lockheed Martin доказала свою эксплуатационную пригодность на БПЛА группы 2.
AMD Virtex UltraScale+ VU13P/VU9P предоставляют чрезвычайно высокую плотность логики и высокоскоростные интерфейсы. VU13P имеет миллионы логических ячеек, многочисленные DSP-блоки и высокоскоростные трансиверы GTY, подходя для сжатия радиолокационных импульсов, обработки сигналов РЭБ и многоканального высокоскоростного сбора данных. Интерфейсы FMC+ подключают высокоскоростные дочерние платы АЦП/ЦАП с поддержкой JESD204B и других протоколов.
AMD Kintex UltraScale+ XQRKU060 представляет радиационно-стойкое направление, поддерживая неограниченную орбитальную реконфигурацию — подходит для БПЛА или платформ ближнего космоса в высокорадиационных средах.
VI. Типовые конфигурации на платформе Дуюань Электроникс
Решение 1: интегрированная платформа задач вычислений (ориентация MPSoC)
С платой разработки ZU19EG в качестве ядра: сторона PS работает под Linux + PX4/ROS 2, ядра Cortex-R5 выполняют критически важное управление ориентацией, а сторона PL реализует предобработку датчиков и ускорение ИИ-вывода. Подходит для средних и крупных БПЛА, одновременно обрабатывающих управление полётом, визуальную навигацию и распознавание целей. Дуюань Электроникс предоставляет универсальное полностековое решение FPGA для этой платформы — от аппаратного проектирования, разработки логики и кастомизации IP-ядер до встраиваемой разработки ПО — помогая командам быстро завершить полный процесс от верификации выбора до развёртывания прототипа.
Решение 2: выделенная платформа обработки сигналов (чистый FPGA)
С платой разработки VU13P в качестве ядра подключайте высокоскоростные дочерние платы АЦП/ЦАП через интерфейсы FMC+ для построения системы обработки радиолокационных сигналов или РЭБ. 1 728K логических ячеек VU13P и 12 288 DSP-блоков достаточны для реализации аппаратных конвейеров многоканального сжатия импульсов, БПФ и согласованной фильтрации. Подходит для военных или специальных задач БПЛА с экстремальными требованиями к детерминированной задержке.
Решение 3: архитектура гетерогенного совместного проектирования (MPSoC + независимый FPGA)
Используйте ZU19EG как основную управляющую вычислительную платформу, подключая VU13P через PCIe Gen3 x16 или высокоскоростные линии GTY как выделенный сопроцессор. ZU19EG обрабатывает управление полётом, целевое управление и системное планирование, в то время как VU13P обрабатывает реальную обработку сигналов на радиолокационном или РЧ-фронте РЭБ. Это разделение сочетает экосистему ПО с аппаратным детерминизмом — общая форма сегодняшних самых высокоуровневых вычислительных архитектур БПЛА.
Заключение
Ответ на вопрос «чистый FPGA или MPSoC» лежит не в том, какой чип изначально лучше, а в напряжении между требованиями детерминизма нагрузок и изменчивостью алгоритмов. Чистый FPGA незаменим для наносекундного детерминизма и выделенной обработки сигналов; MPSoC удерживает преимущество в системной интеграции, гибкости ПО и изоляции многозадачности. Проектирование архитектуры высокоуровневых БПЛА по сути заключается в том, чтобы позволить каждому классу вычислительных задач приземлиться на наиболее подходящее оборудование: задачи управления полётом реального времени выполняются на ядрах Cortex-R5, ИИ-вывод работает на Cortex-A53 с ускорением FPGA, а обработка радиолокационных сигналов завершается в аппаратных конвейерах чистого FPGA.
С продуктовыми линейками ZU19EG и VU13P, охватывающими полный технический спектр от MPSoC до чистого FPGA, Дуюань Электроникс вместе со своим универсальным полностековым решением FPGA обеспечивает сквозную поддержку — от чипа до системы — для верификации выбора и инженерной реализации высокоуровневых вычислительных архитектур БПЛА.