Массив камер на плате: как FPGA/MPSoC выполняет реалтайм-ИИ-вывод на краю
Когда четыре камеры линии целиком передаются на центральный сервер для детекции, не хватает полосы и не сжимается задержка. Правильнее: захват, предобработка и вывод выполняются на самой плате, наружу идут только результаты и сжатая превью. Статья делит краевую бортовую ИИ-архитектуру на роли PS/PL, с бюджетом полосы и путём развёртывания модели.
1. Почему ИИ-вывод переносят на плату
Старый централизованный подход при нескольких камерах: каждая камера на коммутатор, сырые потоки на центральный сервер, серверный GPU выполняет детекцию по всему. При малом числе камер это работает, на большем числе каналов всплывают две проблемы: огромная несжатая сырая полоса и неизбежные сетевые задержки и очереди централизованного вывода.
Сначала расчёт сырой полосы: один поток 1080p30 YUV422 (2 байта на пиксель) = 1920×1080×2×30 ≈ 124 МБ/с ≈ 995 Мбит/с; четыре канала складываются примерно в 4 Гбит/с несжатого потока, до серверного декодирования, очередей и кодирования. На таком уровне стоимость канала и сквозная задержка централизованной архитектуры почти не снижаются.
Бортовая схема переворачивает это: предобработка и вывод идут локально на плате, наружу уходят только структурированные результаты (рамка, класс, достоверность, несколько КБ на кадр) плюс одно сжатое превью; сырые пиксели не покидают плату.
2. Бортовая ИИ-архитектура: что берут PS и PL
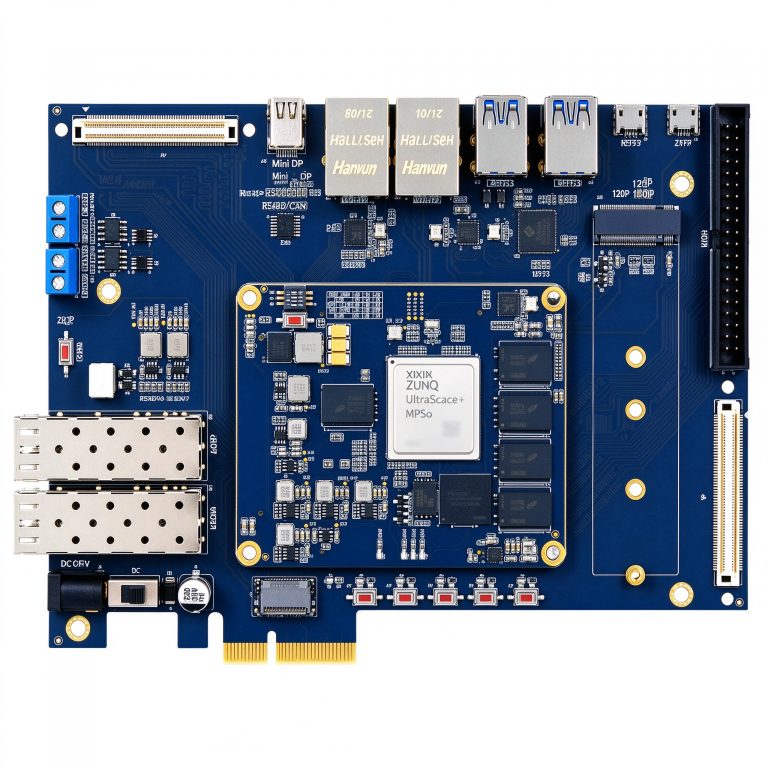
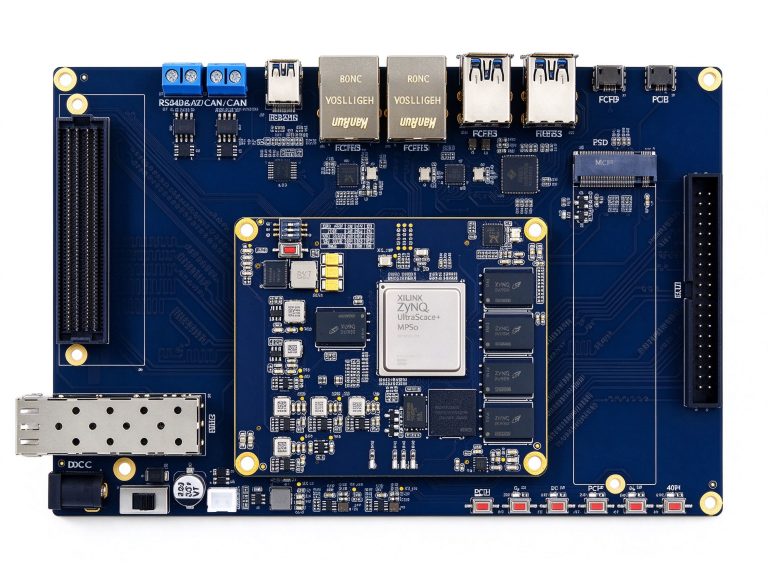
Zynq UltraScale+ MPSoC размещает четырёхъядерный A53 (PS) и программируемую логику (PL) в одном чипе, соответствуя «планирование плюс система» и «параллельные тракты данных».
1. PL: конвейер захвата и предобработки
Сигналы камер (MIPI CSI, USB или GigE) поступают в PL, где аппаратный параллелизм сначала выполняет шумоподавление, масштабирование, переход цветового пространства и нормализацию формата. Эти операции естественно попиксельные и параллельные; конвейер PL делает их намного быстрее последовательной CPU и освобождает A53.
2. PL: параллельный вывод квантованных моделей
Свёртка, пулинг и активация выполняются в PL как параллельный массив DSP-срезов: веса хранятся в он-чип BlockRAM/UltraRAM или в DDR4 стороны PL, входные карты признаков текут через массив умножения-накопления. После INT8-квантования резко падают размер модели и трафик памяти. PL не запускает ОС; её детерминированный конвейер держит фиксированный такт на кадр.
3. PS: планирование, Linux и отчёт результатов
PS-четырёхъядерный A53 работает под Linux для планирования задач, связи с хостом и упаковки результатов; встроенный VCU-кодер одновременно сжимает одно превью в H.264/H.265 и отправляет его по сети только при необходимости просмотра.
3. Бюджет полосы: почему сырой многокамерный поток нельзя возвращать
| Этап тракта | Один 1080p30 | Четыре канала | Примечание |
|---|---|---|---|
| Сырой несжатый (YUV422) | ~995 Мбит/с | ~4,0 Гбит/с | Старое полное возвращение на сервер |
| Структурированный результат после предобработки | несколько КБ/кадр | несколько КБ/кадр | рамка + класс + достоверность |
| Сжатое превью (H.264) | 2–4 Мбит/с | 8–16 Мбит/с | Отправляется только при просмотре |
Бортовая обработка снижает исходящую полосу с Гбит/с до Мбит/с или даже Кбит/с; центральный сервер получает только результаты и больше не резервирует декодирование и вывод под каждую камеру. Граница «сырые пиксели на плате, наружу только результаты» — ключевое преимущество краевой схемы.
4. Развёртывание модели и выбор платы
1. Сначала квантование и обрезка
Квантуйте модель в INT8, обрежьте и ужимайте веса для снижения объёма; затем разрежьте послойные конвейеры по он-чип памяти и ёмкости DSP, чтобы не заносить всю таблицу весов разом. Поток типа Vitis-AI компилирует, квантует и разворачивает модель на PL-ускорителях, PS-Linux по-прежнему хостит приложение.
2. Плата по числу каналов и вычислительной мощности
Роли краевых зрительных плат: стартовый прототип / многоканальная мощность / чистая FPGA-параллельность
- Стартовый краевой прототип (DUUZ4EV, запрос): XCZU4EV, 192K логических ячеек, 728 DSP, встроенный VCU, PS 4GB + PL 4GB DDR4; для краевых ИИ-прототипов с одной-двумя камерами и быстрой проверкой на PYNQ.
- Многоканальная высокая мощность (DUUZ5EV, запрос): XCZU5EV, 256K логических ячеек, 1248 DSP, 16 пар GTH, расширение FMC-LPC; платформа для большего числа каналов и тяжёлых моделей.
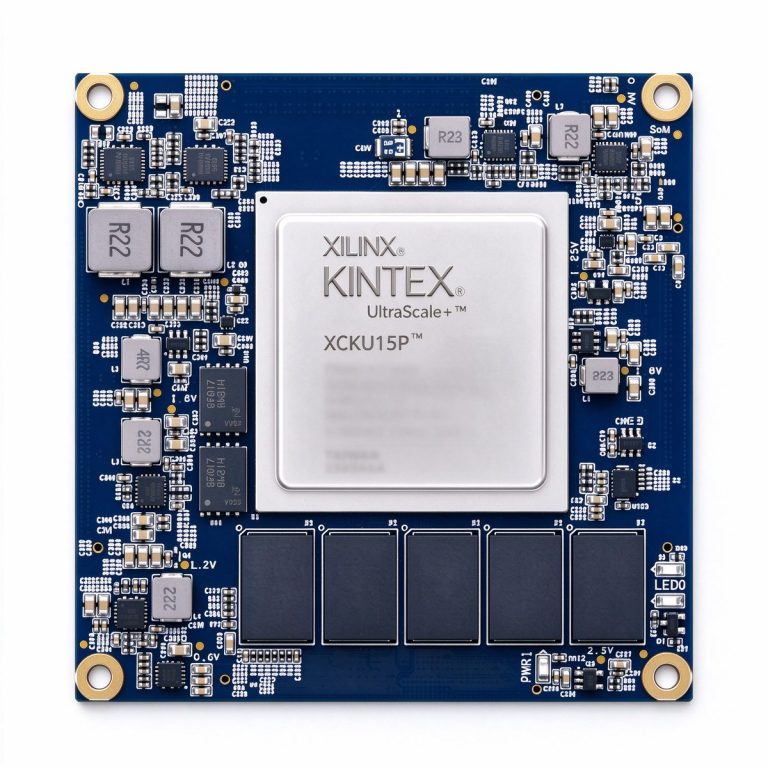
- Чистая FPGA-параллельная расширяемость (XCKU15P, ¥15 999): ядро Kintex UltraScale+ для параллельной многокамерной обработки потоков и агрегации высокоскоростных интерфейсов без PS-системы.
Краевой ИИ-вывод — не уменьшенный серверный GPU, а разделение всей цепочки «захват–предобработка–вывод–отчёт» на плате: PL несёт параллельную попиксельную обработку и квантованную свёртку, PS несёт планирование и связь, VCU попутно сжимает превью. Сырые пиксели остаются на плате, наружу идут только результаты — полоса и задержка ослабляются обе.