Оптоволоконный бэкенд 10G/25G: планирование линейной скорости GTX/GTH и UDP-офлоуда
Когда сходятся несколько высокоскоростных АЦП, радарные лучи или видеопотоки, медный кабель упирается в потолок уже через несколько метров, а PCIe не выходит за пределы корпуса. Правильный бэкенд — напрямую управлять SFP+/QSFP трансиверами GTX/GTH внутри FPGA, разгрузить MAC и стек IP/UDP на кристалле и отправлять по волокну только полезную нагрузку на линейной скорости. В статье разобраны линейная скорость 10G/25G, полезная нагрузка UDP, бюджет линии и разделение задач внутри FPGA.
1. Почему высокоскоростные данные идут по оптоволокну
Внутри платы используется PCIe, для коротких межплатных связей — медь; но когда узлы сбора распределены, расстояние превышает несколько метров, а каждый канал идёт на нескольких Гбит/с, медь и задняя панель первыми упираются в потолок:
1. Потолок расстояния: DAC-кабель на 10G обычно держит лишь 3–5 м, активная медь тоже ограничена; одномодовое волокно с оптическим модулем легко доходит до 10 км и подходит для распределённых антенных решёток и удалённых радарных фронтов.
2. Потолок полосы: одиночный 1080p60, многоканальный промежуточный SDR или объединённый радарный IQ часто превышают 10 Гбит/с; гигабитная медь и задняя панель это не несут, нужен SFP+ (10G) или QSFP28 (25G/100G).
3. Тайминг и помехоустойчивость: в шумном промышленном поле волокно даёт гальваническую развязку, защиту от наводок и петель заземления и более стабильное общее тактирование узлов.
Типовая схема: удалённая карта сбора делает только выборку АЦП и предобработку, пакует результат и по одному волокну шлёт на центральный сервер, который не обрабатывает каналы по отдельности, а лишь принимает агрегированный поток. Здесь линейная скорость канала и накладные расходы протокола напрямую решают, сколько узлов можно подключить.
2. Линейная скорость 10G/25G и бюджет полезной нагрузки UDP (считайте нагрузку до подключения)
Многие принимают «порт 10 Гбит/с» за полезную полосу, но прикладной слой получает только нагрузку после кодирования, межкадрового интервала и заголовков. Сначала откуда берётся линейная скорость:
| Позиция | 10G (SFP+) | 25G (QSFP28) | Примечание |
|---|---|---|---|
| Номинальная скорость Ethernet | 10,0 Гбит/с | 25,0 Гбит/с | Эффективная скорость MAC |
| Линейная скорость после 64b/66b | 10 × 66/64 = <span class=”hl”>10,3125 Гбит/с</span> | 25 × 66/64 = <span class=”hl”>25,78125 Гбит/с</span> | Фактический битрейт на линии |
| Накладные кадра MTU 1500 | преамбула/SFD 8Б + интервал 12Б + Eth 14Б + IP 20Б + UDP 8Б | то же | ~62Б не-нагрузки на кадр |
| Доля полезной нагрузки UDP | 1500/(1500+62) = <span class=”hl”>96,03%</span> | ≈96,03% | без ретраев прикладного слоя |
| Скорость нагрузки UDP (MTU1500) | 10 × 96,03% ≈ <span class=”hl”>9,60 Гбит/с</span> | 25 × 96,03% ≈ <span class=”hl”>24,0 Гбит/с</span> | что реально получает приложение |
| Jumbo Frame (9000Б) доля | 9000/9062 = 99,32% | 99,32% | поднимает нагрузку до ~9,93 / ~24,8 Гбит/с |
Ключевой вывод: при MTU1500 и UDP порт 10G отдаёт приложению лишь ~9,6 Гбит/с, а не 10 Гбит/с. Узлы считайте по нагрузке: если каждый узел шлёт 2 Гбит/с эффективных данных, линия 10G вмещает ~4–5 узлов (9,6 / 2, с запасом), а не полные 5. Чтобы подойти к линейной скорости, включите Jumbo Frame и размажьте фиксированные накладные на кадр.
BER и бюджет линии
Оптоволоконная линия не готова, когда её воткнули: сначала считайте оптический бюджет мощности — излучаемая мощность − чувствительность приёмника = запас линии, из которого вычитается затухание волокна (одномод 1310 нм ≈ 0,35 дБ/км) и потери сварива/коннектора (~0,5 дБ на коннектор). SR-многомод 850 нм ограничен расстоянием и OM3/OM4; LR-одномод 1310 нм доходит 10 км. Нормативная линия нацелена на BER лучше 1e-12; 25G обычно добавляет RS-FEC и исправляет сырые ошибки ~1e-5 до 1e-15, выигрыш кодирования FEC тоже закладывается в бюджет.
3. Как FPGA делит работу
1. Трансиверы GTX/GTH управляют оптическим модулем
GTX серии 7 доходят до 10,3125 Гбит/с — ровно SFP+ 10G; GTH/GTY UltraScale/UltraScale+ работают выше 16G и поддерживают 25G. Трансивер отвечает за сериализацию/десериализацию, кодирование 8b/10b или 64b/66b и восстановление такта; снаружи остаются лишь высокоскоростные пары и управление модулем по I2C (снятие DDM).
2. MAC и обработка кадров
Над трансивером — Ethernet MAC 10G/25G: разделение кадров, проверка CRC, управление потоком PAUSE. Приём отбрасывает кадры с ошибкой CRC и фильтрует по MAC назначения; передача инкапсулирует кадры и заполняет интервалы. Это детерминированный конвейер, полностью под аппаратуру.
3. Движок UDP-офлоуда
Когда CPU пакует IP/UDP по каждому кадру, на 10G это становится узким местом. Офлоуд на кристалле: аппаратура заполняет исходный/целевой IP, порты и контрольную сумму; пользователь лишь пишет нагрузку в DMA-буфер, движок сам добавляет заголовки Eth/IP/UDP, считает контрольную сумму и фрагментирует по MTU. CPU не пакует, а лишь один раз при инициализации настраивает таблицу адресов — это и есть разгрузка стека.
4. Статистика ошибок и контроль линии
Внутрикристалльные счётчики ведут CRC-ошибки, потерянные кадры, правки FEC и периодически отдают по управляющему каналу; также собираются излучаемая мощность, принимаемая оптическая мощность и температура модуля (DDM), чтобы предупредить заранее при падении запаса, а не ждать сбойной картинки.
4. Инженерный пример: распределённый сбор с возвратом по 10G-волокну
Система распределённого сбора имеет 4 удалённых узла; каждый объединяет два промежуточных SDR-канала и один видеоканал, эффективный бэкенд ~2,2 Гбит/с; центр агрегирует по одному 10G-волокну, при Jumbo Frame нагрузка ~9,9 Гбит/с, 4 узла на 8,8 Гбит/с с запасом. Все протоколы — UDP-офлоуд в FPGA, хост получает только нагрузку.
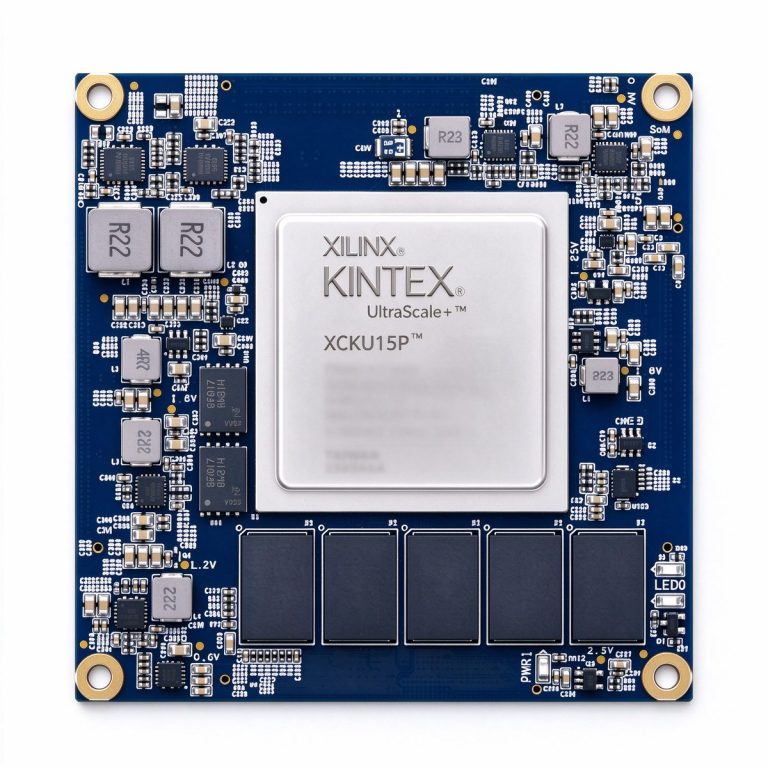
- Широкая полоса связи (XCKU15P / Kintex UltraScale+): запас трансиверов GTY под 25G или несколько каналов 10G, для главного агрегирующего узла с ростом до 25G/100G.
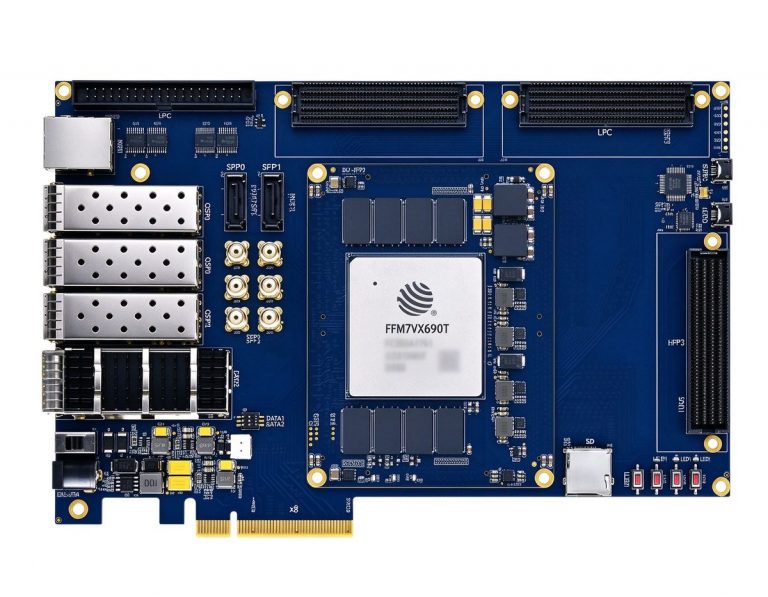
- Ёмкая агрегация (DUF7690T / JFM7VX690T): много логики и внутрикристалльной RAM под несколько MAC, движки UDP-офлоуда и большие очереди, для центральной многоузловой агрегации и линейной пересылки.
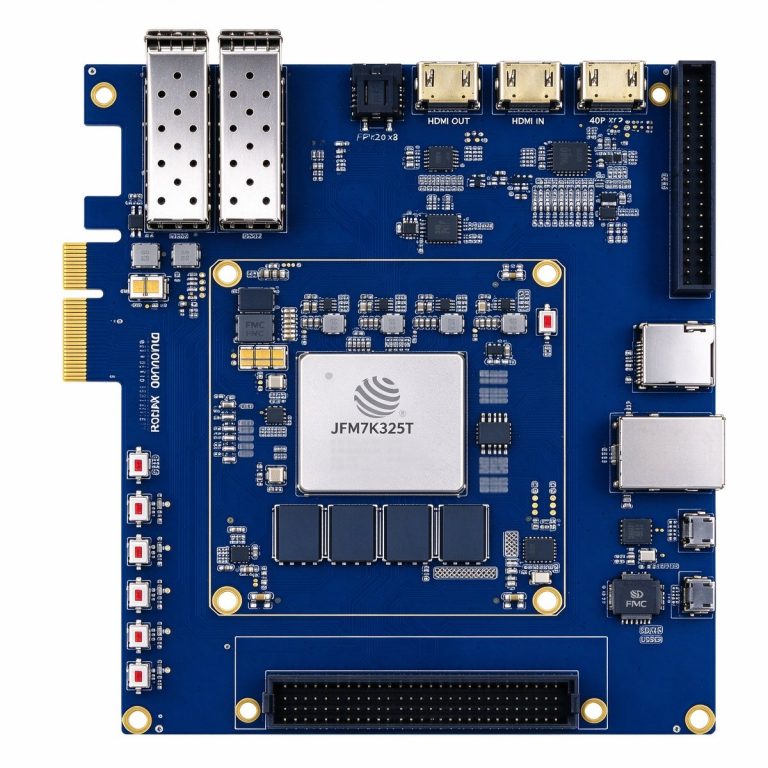
- Вход в 10G-прототип (DUK7325T / JFM7K325T): GTX серии 7 насыщают линейную скорость 10G при сбалансированной цене, для одноузлового 10G-прототипа и начальных продуктов.
Суть оптоволоконного бэкенда — поручить трансиверам и аппаратному стеку FPGA сделать за CPU «отправку на линейной скорости». Держите два числа: при MTU1500 нагрузка 10G ~9,6 Гбит/с, 25G ~24 Гбит/с. Считайте узлы по нагрузке, а не по номиналу, заранее рассчитайте бюджет линии и BER — тогда возврат не просядет в поле.