Где FPGA, GPU и ASIC делят нагрузку ИИ-вывода: стоимость, энергия и гибкость
Команда хочет добавить распознавание объектов 1080p в шлюз, но финансовый отдел отклоняет закупку GPU. Сколько квантованной модели реально вытянет FPGA? Когда действительно нужен GPU? На каком объёме окупается ASIC? В этой статье три пути сведены в одну смету затрат.
1. «Просто возьми GPU» — не единственный ответ для inference
Когда инженеры думают о развёртывании ИИ-вывода, GPU — первая реакция: экосистема CUDA, библиотеки операторов, модель загружается и работает. Но в реальном продукте расклад меняется. GPU нужен активный обдув, десятки Вт, он дорогой, занимает слот PCIe и не лезет в корпус. В шлюзах, встроенных камерах и промышленных edge-боксах, где важны габариты и энергопотребление, GPU часто «пригоден, но не помещается».
Значит, настоящий вопрос: где проходят границы между FPGA и специализированными ASIC (включая NPU/TPU-ускорители)? Какой сегмент нагрузки на каком устройстве? Это не сравнение «кто быстрее» — это задача выбора, jointly определяемая тремя переменными: удельная стоимость, удельная энергия и частота итераций модели.
2. Фундаментальное различие: модель параллелизма и поток данных
Корень различий между тремя классами устройств — в архитектуре, а не в бенчмарке.
| Измерение | GPU | FPGA | ASIC / NPU |
|---|---|---|---|
| Вычислительные блоки | Массив SIMT-потоков | Реконфигурируемый массив LUT + DSP | Фиксированный систолический массив / тензорные ядра |
| Поток данных | Общая видеопамять → пакетная обработка SM | BRAM / регистры на кристалле, сквозной поток | Фиксированный поток через SRAM на кристалле |
| Точность | Сильный нативный FP16/FP32 | Настраиваемый INT8, слабая плавающая точка | Оптимизированный INT8/INT4 |
| Задержка | Очередь пакетов, мс-джиттер | Фиксированный конвейер, мкс-детерминированно | Мкс, фиксированная структура |
| Конфигурация | Драйвер + CUDA Runtime | Битовый поток после synthesis & place-and-route | Неизменяем после tape-out |
GPU запускает «любую модель». FPGA прогоняет данные насквозь, не дожидаясь батча. ASIC крутит одну и ту же модель вечно с максимальной производительностью на ватт. Когда это понятно, все расчёты ниже становятся очевидными.
3. Смета затрат: NRE, стоимость одного вывода, жизненный цикл
Разделите затраты на три части — вывод разойдётся с интуицией.
| Статья затрат | GPU | FPGA | ASIC |
|---|---|---|---|
| Единовременные NRE | Закупка платы, десятки тысяч юаней | EDA-инструменты + люди, человеко-месяцы | Тейп-аут + маски, миллионы юаней |
| Стоимость вывода (железо) | Высокая (избыток универсальной мощности) | Средняя (под задачу) | Очень низкая (амортизируется тиражом) |
| Цена изменения модели | Переписать CUDA-ядро, недели | Пересинтез, дни–недели | Невозможно, новый тейп-аут |
| Оптимальный тираж | Любой | Тысячи–миллионы | Сотни тысяч+ |
Ключевая кривая — амортизация NRE: NRE FPGA — это в основном время инженеров, она не размазывается на цену кристалла. NRE ASIC огромна, но себестоимость штуки обрушивается с ростом тиража. Практика: при годовом тираже от нескольких тысяч до десятков тысяч штук FPGA обычно оптимален по цене. Только при сотнях тысяч в год и стабильной модели 2–3 года NRE ASIC начинает отбиваться.
4. Энергопотребление и охлаждение: самый чувствительный edge-показатель
В edge-устройствах энергия напрямую определяет систему охлаждения и габариты корпуса.
| Путь | Типичное энергопотребление | Охлаждение |
|---|---|---|
| Топовый GPU (инференс-карта) | 35–70 Вт | Активный вентилятор |
| Средний/низовый GPU / iGPU | 10–25 Вт | Пассивный обдув |
| Средний/большой FPGA | 8–25 Вт (можно ужать до <5 Вт) | Пассивный радиатор |
| Специализированная NPU / ASIC | 2–8 Вт | Пассивный радиатор |
Преимущество FPGA не в «высшей пиковой мощности», а в том, что можно удалить всю ненужную логику. Оставить только свёрточные ядра, квантовательный бэкенд и DMA-каналы, нужные детектору. Kintex-класс FPGA, крутящий INT8-детекцию, часто держит всю плату около 10 Вт. В промышленном edge-боксе без вентилятора это решающий аргумент.
5. Гибкость и скорость итераций: цена смены модели
Промышленные ИИ-проекты редко фиксируются с первого раза. Алгоритмические команды каждый квартал меняют backbone, квантование и постобработку. Здесь три пути расходятся очень сильно:
- GPU: PyTorch → реэкспорт в TensorRT; неподдерживаемые операторы = ручное ядро; одна адаптация — часы–дни.
- FPGA: Квантованная сеть, отверждённая в RTL-конвейер; повторный synthesis & place-and-route — часы; новый оператор — RTL или HLS, несколько человеко-дней.
- ASIC: Кристалл запечатан. Смена модели = патчи на верхнем уровне; реальные структурные изменения — только следующий чип.
Вывод прямой: не трогайте ASIC, пока модель быстро итерируется. FPGA занимает единственную нишу, где нужна детерминированность на уровне железа, но при этом модель, скорее всего, поменяется в течение полугода.
6. Матрица решений: какой сценарий — какой путь
Сводим три линии в матрицу для прямого сопоставления:
| Сценарий | Рекомендуемый путь | Почему |
|---|---|---|
| Облачный пакетный вывод, частые обновления модели | GPU | Экосистема и пропускная способность в приоритете |
| Edge-бокс, <10 Вт, детерминированная задержка | FPGA | Лучшая энергия и детерминизм |
| Встроено в камеру, 100k+ в год, модель зафиксирована | ASIC/NPU SoC | Минимальная себестоимость штуки |
| Лабораторный прототип, демо нужно быстро | GPU | Самая быстрая разработка |
| Мультипротокол + ИИ на одном кристалле | FPGA | Программируемая логика, без второго моста |
Типичная ошибка: увидев «ИИ», по умолчанию брать GPU. В сценариях, где «ИИ-предобработка + реальная бизнес-логика» сосуществуют — например, усиление изображения, детекция, приём GbE и GPIO одновременно — FPGA самый экономичный способ собрать всё на одном кристалле. GPU отвечает только за ИИ-часть и заставляет добавлять отдельный MCU-мост для протоколов.
7. Где три платы Duyuan попадают в эти ниши
Соотносим матрицу с актуальными платами Duyuan:
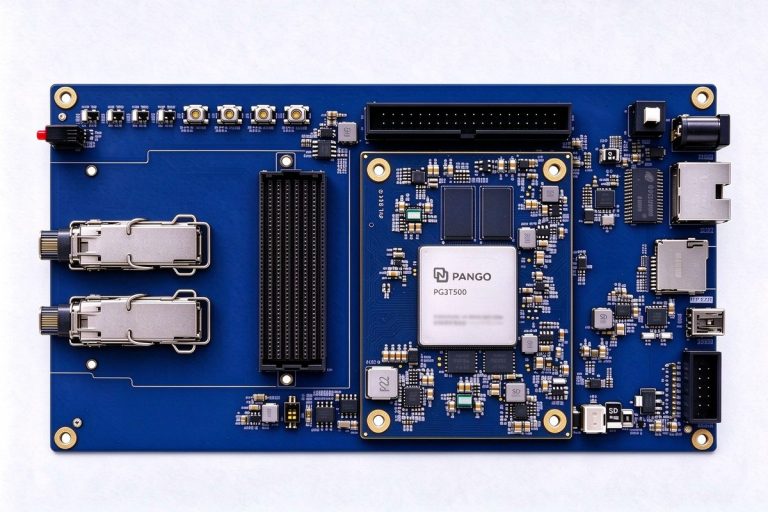
- DUPG3T500 (Pango Titan3, ~¥5 999): Отечественная высокопроизводительная платформа разработки на FPGA, для прототипирования INT8-квантованных моделей в железе и прямого запуска малосерийных шлюзовых продуктов.
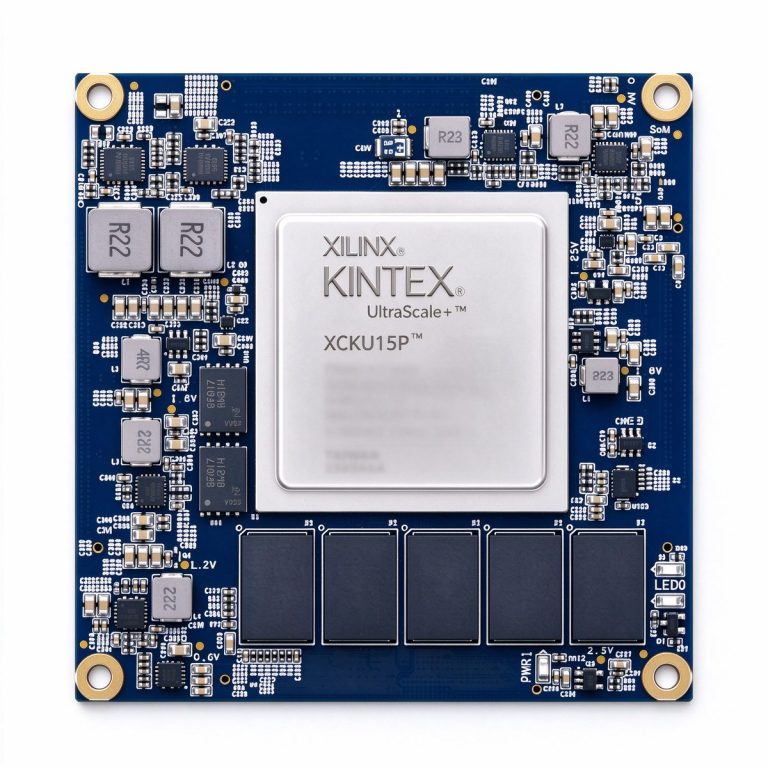
- DUKU15P (Xilinx Kintex UltraScale+ XCKU15P SOM, ~¥17 999): Большая логика + высокоскоростные трансиверы, для среднего- и высокоуровневых продуктов, где ИИ-вывод живёт рядом с несколькими каналами 10G.
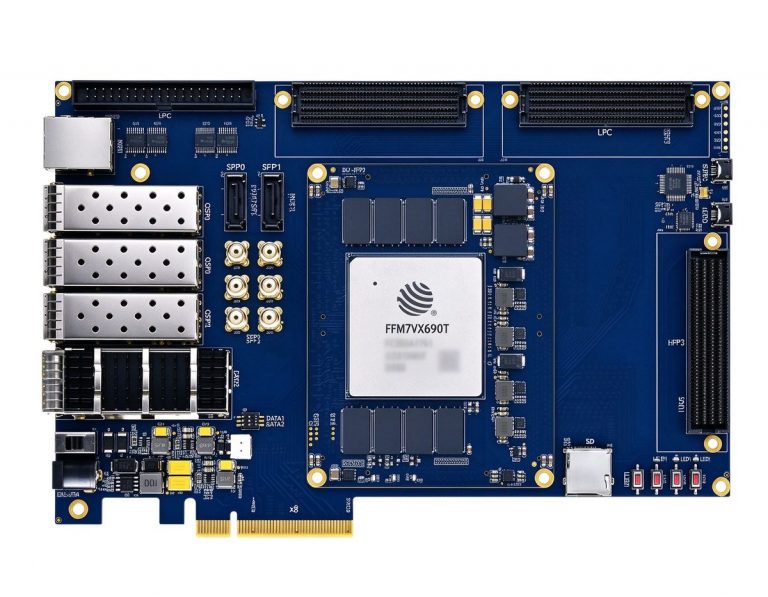
- DUF7690T (FudanMicro JFM7VX690T, pin-совместим с XC7VX690T, ~¥24 999): Индустриальная отечественная платформа Virtex-7 для отверждённого вывода и долгосрочных поставок в высоконадёжных применениях.
| Плата | Ниша | Типичная ИИ-нагрузка |
|---|---|---|
| DUPG3T500 | Прототип / малосерийный шлюз | INT8-детекция, классификация |
| DUKU15P | Средний-высокий + высокоскоростной I/O | Многоканальная детекция + 10G-восходящий канал |
| DUF7690T | Индустриальный долгий жизненный цикл | Отверждённая модель + высоконадёжные поставки |
8. Чек-лист внедрения
Ведите edge-ИИ-проект в этом порядке — избежите большей части переделок:
- Сначала фиксируйте бюджет задержки и энергии, потом обратно считайте мощность: вентиляторные edge-устройства упираются в 5–15 Вт суммарно, GPU сразу выбывает.
- Модель сначала отладьте на GPU, квантуйте до INT8, потом думайте об отверждении на FPGA — не отлаживайте алгоритмы на FPGA.
- Годовой тираж <100k, модель сменится в течение года: FPGA; на этом этапе об ASIC даже не заикайтесь.
- Годовой тираж сотни тысяч, модель стабильна два поколения: тогда начинайте NRE-анализ ASIC/NPU.
- Когда сбор, протокол и ИИ живут в одном продукте — сначала оценивайте однокристальную FPGA-интеграцию, а не GPU + host MCU.
Выбор устройства для ИИ-вывода — это не «у кого больше FLOPs». Это вопрос о том, кто выигрывает в уравнении удельной стоимости в зазоре между бюджетом энергии и ритмом итераций модели. FPGA — не замена GPU; он занимает ту самую edge-позицию, где расчёт действительно сходится.
Дополнительное чтение
- Как выбрать FPGA: матрица ресурсы × трансиверы × цена
- Многокамерная бортовая ИИ-инференция: смета edge-развёртывания
- MPSoC, чистый FPGA, MCU+ARM: три гетерогенных пути