Обработка сигналов фазированной антенной решётки: многоканальное формирование луча и сжатие импульсов на FPGA
Фазированная решётка наводится на цель электронно, без подвижных частей. Основная нагрузка — не антенна, а задняя часть: каждый канал отражённого сигнала должен одновременно выполнять цифровое формирование луча, сжатие импульса и обнаружение цели. В статье эта цепочка разбирается на считаемые скорости данных и бюджеты ресурсов, а также показано построение на платах FPGA.
Почему фазированным решёткам нужен FPGA
Обычный механически сканирующий ракурс смотрит в одну сторону за раз, поэтому задняя часть обрабатывает только один тракт сигнала. В ФАР N излучателей, за каждым — свой приёмо-передающий модуль и АЦП. N потоков эха должны одновременно поступать в цифровую область, чтобы формировать лучи цифровым способом (DBF).
Это задаёт два жёстких ограничения:
- Очень высокая скорость данных: N каналов АЦП работают параллельно; чем больше N и выше частота дискретизации, тем большую полосу требует задняя часть;
- Крайне низкая задержка: формирование луча и сжатие импульса — конвейерная обработка, нельзя накопить пачку и считать; решётка должна успеть за период импульса, иначе придёт следующий.
CPU и GPU не дают детерминированной параллельной многоканальной обработки в микросекундном конвейере — именно здесь место FPGA.
Полная цепочка обработки радиолокационного сигнала
Типовая цифровая задняя часть ФАР от АЦП до отметки цели устроена так:
1. Многоканальный захват АЦП: один канал на излучатель, 12–16 бит, частота от десятков до сотен MSPS;
2. DDC цифровое понижение частоты: поканальное смешивание + фильтр нижних частот + децимация до комплексного сигнала основной полосы (I/Q);
3. DBF цифровое формирование луча: N потоков основной полосы взвешиваются комплексными коэффициентами и суммируются по направлению на цель;
4. Сжатие импульса (согласованная фильтрация): сжатие ЛЧМ-сигнала в узкий импульс для повышения разрешения по дальности;
5. CFAR обнаружение с постоянной ложной тревогой: выявление целей на сжатых данных и подавление помех;
6. Извлечение отметок и передача: обнаруженные дальность/азимут/амплитуда упаковываются и отправляются на хост.
FPGA объединяет шаги 2–5 в одной тактовой области и проходит всю цепочку за каждый период импульса (десятки–сотни микросекунд).
Расчёт скорости данных
Возьмём 16-канальную решётку с 125 MSPS и 14 бит на канал:
| Этап | Формула | Результат |
|---|---|---|
| Сырая скорость одного канала | 125 MSPS × 14 бит | 1,75 Gbps ≈ 218 МБ/с |
| Суммарно по 16 каналам | 16 × 1,75 Gbps | 28 Gbps ≈ 3,5 ГБ/с |
| Комплексная скорость после DDC | 16 к × 125 MSPS × (16 бит I + 16 бит Q) | 8 Gbps ≈ 1 ГБ/с |
| Пропускная способность комплексных умножений DBF | 16 к × 125 М отсчётов/с × 1 компл. умн. | 2 G complex MAC/s |
| БПФ сжатия импульса 4096 точек | 125 MSPS ÷ 4096 | ≈ 30 БПФ на канал в секунду |
Ключевая цифра: 16 параллельных каналов, 3,5 ГБ/с сырых данных в заднюю часть. Последовательные высокоскоростные линии JESD204B/C созданы именно для этого — каждый АЦП занимает одну последовательную линию вместо широкой параллельной шины.
Что потребляют DBF и сжатие импульсов
Цифровое формирование луча (DBF)
По сути DBF — это N комплексных потоков, каждый умножается на комплексный вес w(n), затем суммируется.
- Каждый отсчёт требует N комплексных умножений (4 вещественных умножения + 2 сложения);
- При N=16 за такт параллельно выполняются 16 комплексных умножений — DSP-блоки FPGA естественно параллельны;
- Веса w(n) рассчитываются по углу на цель (w(n)=e^(-j·2π·n·d·sinθ/λ)) и хранятся в виде таблиц.
FPGA выполняет DBF практически без накладных расходов на инструкции — просто заполняет DSP-блоки параллельными умножениями-накоплением.
Сжатие импульса (согласованная фильтрация)
Стандартный метод сжатия ЛЧМ — «частотный»: БПФ входа × коэффициенты фильтра → ОБПФ.
- БПФ 4096 точек, одно на канал;
- В FPGA есть готовый поточный IP БПФ с фиксированной микросекундной задержкой;
- 16 каналов могут делить одно ядро БПФ или запускать 16 параллельно.
БПФ 4096 точек одинарной точности занимает несколько сотен DSP-блоков и несколько Мбит BRAM — свободно размещается на плате уровня XCKU15P.
Три класса плат
Разное число каналов и частота обновления требуют разных ресурсов FPGA:
| Плата | Платформа FPGA | Масштаб РЛС | Почему |
|---|---|---|---|
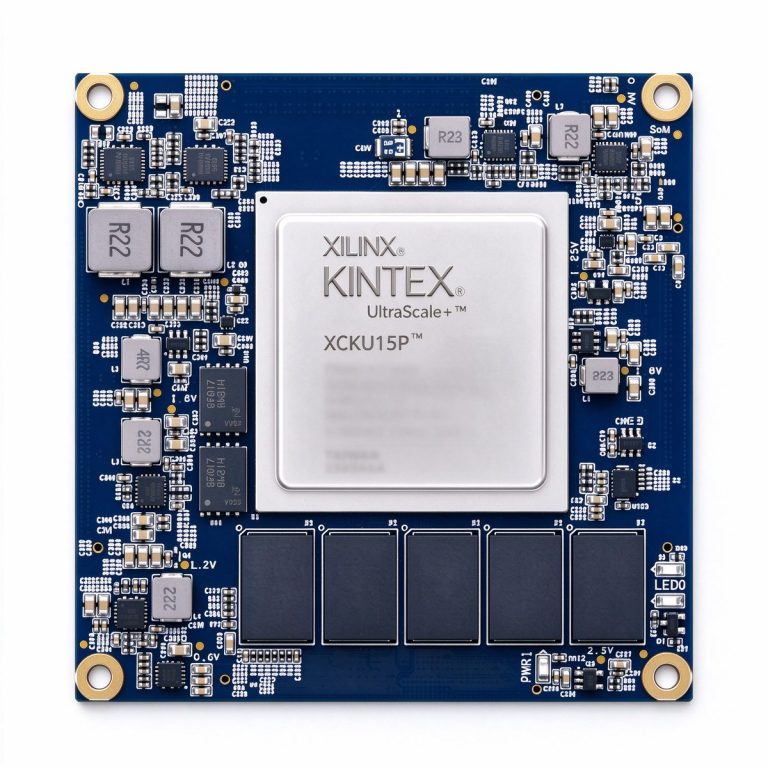
| СОМ XCKU15P | Kintex UltraScale+ | 16–64 канала, скоростная ближняя РЛС | Много логики, трансиверы GTH под несколько линий JESD204B/C, хватает DSP на параллельный DBF и многоканальное БПФ |
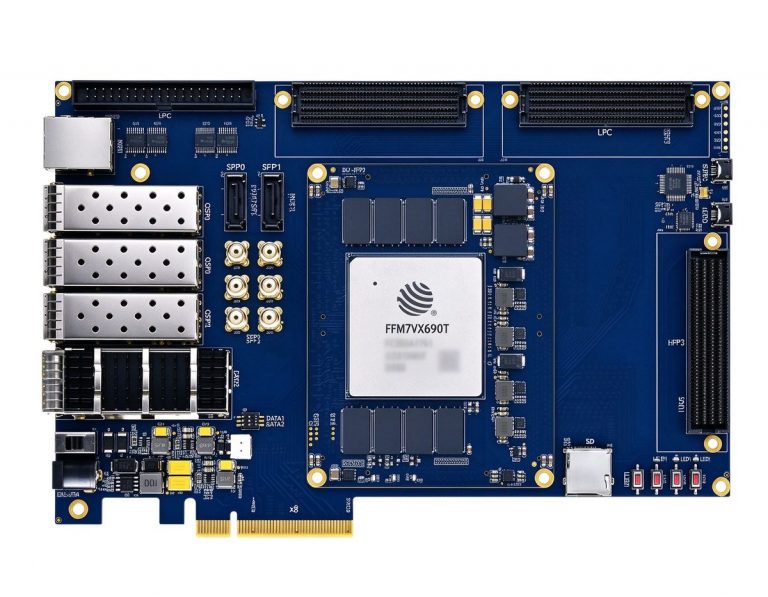
| DUF7690T | FudanMicro JFM7VX690T (совместим с XC7VX690T) | Импортонезависимый высоконадёжный узел РЛС | Класс Virtex-7, промышленный температурный диапазон, для автомобильных и охранных РЛС с требованиями к надёжности |
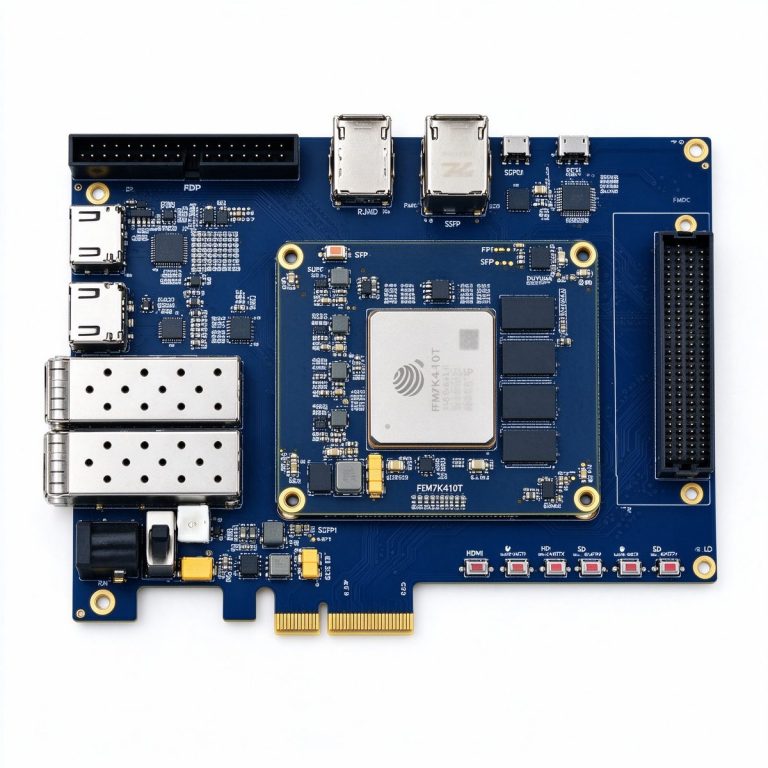
| DUK7410T | FudanMicro JFM7K410T (совместим с XC7K410T) | 4–8 каналов, недорогой прототип | Класс Kintex-7, ниже стоимость; хватает на DBF малой решётки и одноканальное сжатие, для отработки алгоритмов и малых серий |
Типичное разделение: команда алгоритмов отрабатывает форму сигнала и обнаружение на 4 каналах DUK7410T, затем переносит на DUF7690T для импортонезависимого производства или на XCKU15P для решёток крупнее.
Пример: 16-канальная ближняя охранная РЛС
Ближняя охранная РЛС использовала линейную решётку из 16 элементов на 10 ГГц, полоса 100 МГц, ЧПИ 5 кГц:
- 16 каналов АЦП подавались в FPGA по JESD204B;
- DDC понижал каждый канал до комплексной основной полосы 10 МГц;
- DBF формировал 4 одновременных приёмных луча по разным азимутам;
- Частотное сжатие импульса 4096 точек сжимало импульс 20 мкс до разрешения около 5 м по дальности;
- CFAR по среднему выводил отметки целей на хост через PCIe.
Замер: задержка обработки одного импульса около 80 мкс, заметно меньше периода 200 мкс; загрузка FPGA около 60 % (DSP и BRAM).
Электронное сканирование фазированной решётки звучит как задача антенны, но реальное поле битвы вычислений — внутри FPGA: многоканальная параллельность, микросекундный конвейер, детерминированная задержка. CPU так не умеет, FPGA создан для этого.
Читать также
- [Широкополосный SDR-фронтенд: высокоскоростная цепочка захвата](/article/sdr-wideband-frontend-signal-chain/)
- [Оптика 10G/25G: дальние высокоскоростные каналы](/article/fiber-backhaul-10g-25g/)
- [Дерево тактов и бюджет джиттера: проектирование такта дискретизации](/article/clock-tree-jitter-budget/)