VU13P в количественной торговле: аппаратная платформа с низкой задержкой от декодирования рыночных данных до исполнения ордеров
Суть количественной торговли — за минимально возможное время завершить информационный цикл «поступление рыночных данных → вычисление сигнала → отправка ордера». В этой статье платформа AMD Virtex UltraScale+ XCVU13P (VU13P) рассматривается как основная линия: объясняется, почему она подходит для количественной торговли и как развернуть её в поставляемую низколатентную торговую цепочку.
Суть количественной торговли — за минимально возможное время завершить информационный цикл «поступление рыночных данных — вычисление сигнала — отправка ордера». В микросекундном масштабе времени торговой системы биржи задержка сама по себе является издержкой: опоздание на одну микросекунду означает проскальзывание цены, упущенные возможности или провал всей стратегии. За последние десять с лишним лет ведущие проприетарные торговые фирмы постепенно переносили наиболее критические части цепочки с программного обеспечения на CPU на аппаратуру FPGA — декодирование рыночных данных на карте, стакан заявок на карте, стратегические решения на карте, генерация ордеров на карте. В этой статье платформа AMD Virtex UltraScale+ XCVU13P (VU13P) рассматривается как основная линия: обсуждается, почему она подходит для количественной торговли и как развернуть её в поставляемую низколатентную торговую цепочку.
1. Структура задержек в количественной торговле: почему ответ — FPGA
Типичная автоматизированная торговая цепочка — от поступления пакета рыночных данных на сетевую карту до отправки ордера с сетевой карты — последовательно проходит сетевой стек, разбор рыночных данных, ведение стакана заявок, вычисление сигналов, проверки риска и кодирование ордеров. В программном стеке прерывания ядра, обработка сетевого стека, планирование потоков и промахи кэша вносят неконтролируемый джиттер; аппаратная реализация превращает эти этапы в фиксированную глубину конвейера с детерминированной задержкой, без прерываний и без планирования. Ориентировочная сквозная задержка tick-to-trade для разных способов реализации:
Таблица: сравнение сквозной задержки tick-to-trade (по открытым источникам)
| Способ реализации | Типичная сквозная задержка |
|---|---|
| Обычное ПО + сетевой стек ядра | 10–100 мкс |
| ПО с обходом ядра (DPDK / Onload + привязка ядер) | 1–5 мкс |
| Полная цепочка на FPGA (разбор → стратегия → ордер) | 300 нс – 1 мкс |
| Предварительно настроенный триггер на FPGA (совпадение шаблона и отправка) | 30–100 нс |
| Коммутатор уровня 1 (чистое размножение/копирование) | около 5 нс |
Три свойства FPGA определяют этот разрыв на порядки: параллельность — несколько потоков рыночных данных и экземпляров стратегий работают в аппаратуре одновременно, не конкурируя; детерминированность — нет прерываний и планирования, задержка обработки каждого пакета фиксирована, что одинаково важно для контроля риска и аудита; близость — оптические порты подключаются напрямую к FPGA в обход PCIe и сетевого стека, пакеты декодируются по мере поступления. Отраслевые открытые данные это подтверждают: отдельные решения заявляют сквозную задержку tick-to-trade менее 100 нс, эталонное решение AMD с партнёрами для CME достигает задержки предварительно настроенного триггера на уровне 25 нс; статья 2025 года в журнале «Компьютерные приложения и программное обеспечение» о системе ускорения рыночных данных со сверхнизкой задержкой на основе OpenCL достигла минимальной обработки рыночных данных 678 нс на Alveo U50 при пропускной способности 38,4 Гбит/с — примерно 12-кратное улучшение производительности по сравнению с программным подходом.
2. Обзор возможностей платформы VU13P
VU13P относится к семейству AMD Virtex UltraScale+ и является представительным устройством в точке баланса «масштаб логики × высокоскоростные интерфейсы». Согласно официальной документации AMD, её ключевые характеристики:
Таблица: ключевые характеристики XCVU13P (источник: официальная страница AMD Virtex UltraScale+)
| Показатель | Спецификация XCVU13P |
|---|---|
| Системные логические ячейки | 3 780K (около 3,78 млн логических ячеек) |
| DSP-блоки | 12 288 |
| Высокоскоростные трансиверы GTY | 128 пар (до 32,75 Гбит/с на пару) |
| Пользовательские I/O | 832 |
| Встроенные высокоскоростные интерфейсы | PCIe Gen3 x16, MAC 100G Ethernet, 150G Interlaken (аппаратные блоки в кристалле) |
| Производительность DSP | до около 38 TOP/s |
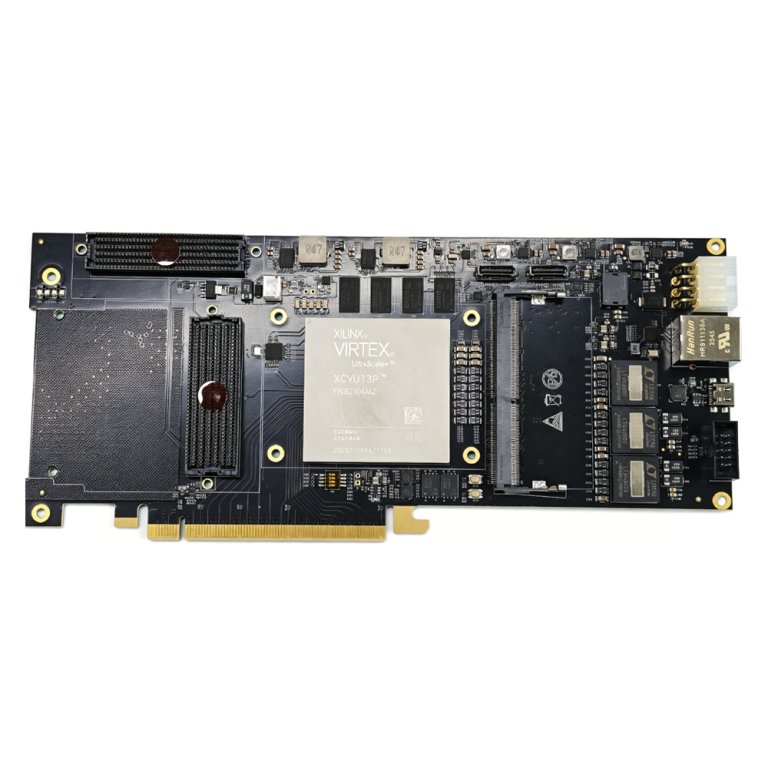
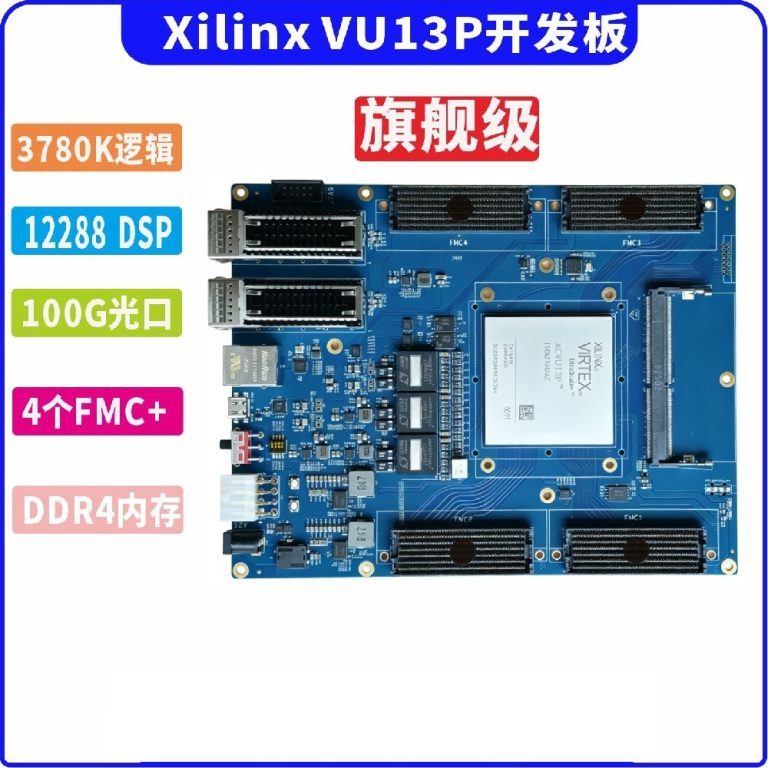
На уровне платы сверхвысокопроизводительная платформа разработки VU13P от Duyuan Electronics предлагает золотые контакты PCIe Gen3 x16, несколько оптических портов 100G (QSFP28), высокоскоростное расширение FMC+, расширение DDR4 SODIMM и промышленный диапазон температур от -40 °C до 85 °C. Для количественной торговли эта плата естественным образом даёт три вещи: прямое подключение нескольких биржевых потоков к FPGA (оптические порты + GTY), размещение значительной стратегической логики внутри FPGA (3,78 млн логических ячеек + 12 288 DSP) и высокополосную двунаправленную связь с хостом (PCIe Gen3 x16).
3. Четыре ключевых применения VU13P в цепочке количественной торговли
3.1 Декодирование рыночных данных и предварительная обработка (Feed Handler)
Биржевые протоколы рыночных данных (NASDAQ ITCH, CME MDP3, формат FAST, распространённый на европейских биржах, и др.) поступают с чрезвычайно высокой скоростью пакетов; программный разбор требует покадрового декодирования, проверки и восстановления структур и является самым ранним и типичным узким местом цепочки. На VU13P разбор рыночных данных реализован как аппаратный конвейер: пакеты декодируются как потоки байтов по мере поступления на оптический порт, извлечение полей, проверка и сборка протокола выполняются за фиксированные стадии конвейера, а несколько потоков (несколько бирж, линии A/B «основная/резервная») обрабатываются параллельно. 128 трансиверов GTY и несколько оптических портов 100G обеспечивают достаточную пропускную способность для одновременных подключений; для бирж с дублированными линиями «основная/резервная» (например, линии A/B CME) в аппаратуре можно реализовать арбитраж линий и бесшовное переключение, чтобы избежать пропусков рыночных данных из-за джиттера одной линии. Распарсенные стандартные структуры рыночных данных записываются непосредственно в кристальную память и используются последующими стратегическими модулями, не проходя через CPU хоста.
3.2 Аппаратный стакан заявок и параллельное исполнение стратегий
Ведение запрашиваемого стакана заявок требует частых операций вставки, удаления, изменения и сортировки; программные реализации опираются на доступ к памяти и блокировки, аппаратные реализации отображают ценовые уровни непосредственно на структуры Block RAM в кристалле, при этом поиск цены и решение о сопоставлении выполняются за фиксированные циклы. На этой основе 3,78 млн логических ячеек VU13P позволяют запускать несколько экземпляров стратегий параллельно на одном устройстве: разные инструменты, разные рынки и даже разная стратегическая логика (маркет-мейкинг, межрыночный арбитраж, арбитраж задержки, статистическая регрессия) могут занимать независимые логические разделы, совместно используя один и тот же распарсенный поток рыночных данных, не мешая друг другу. Для чувствительных к задержке триггерных стратегий можно использовать подход «предварительно настроенного ордера»: шаблоны ордеров заранее записываются в буфер передачи; когда аппаратура обнаруживает заданное условие (пробой цены, изменение соотношения объёмов), она напрямую инициирует отправку, минуя программный путь принятия решений, сжимая задержку до десятков наносекунд.
3.3 Предторговый риск (Pre-Trade Risk)
Биржи и требования комплаенса предъявляют всё более строгие требования к алгоритмической торговле: проверки ценового диапазона, лимита количества на один ордер, совокупной дневной позиции, частоты ордеров и другие должны завершаться до отправки ордера. Проблема программных проверок риска в том, что они сами находятся на критическом пути и добавляют задержку; проверки риска на FPGA размещают логику проверок параллельно пути ордеров — каждый ордер проходит несколько стадий проверок в аппаратном конвейере и при одобрении немедленно кодируется и отправляется, при отклонении блокируется за наносекунды. Правила риска настраиваются через регистры/таблицы памяти и могут обновляться «на лету» в течение торгового дня, что удовлетворяет требованиям комплаенса, не жертвуя низкой задержкой основного пути.
3.4 Бэктестинг, симуляция и ускорение НИОКР
Помимо производственной цепочки, большие логические ресурсы VU13P поддерживают и разработку стратегий: загружайте на плату разработки движки воспроизведения рыночных данных и симуляции для аппаратного бэктестинга на исторических данных, запускайте несколько стратегий параллельно — это значительно быстрее программной симуляции; используйте Vivado/Vitis HLS для быстрого переноса алгоритмов C/C++ на аппаратные реализации, сокращая цикл итераций «идея стратегии → тестируемая аппаратура». Типичная инженерная организация — «FPGA выполняет производственный путь, CPU — мониторинг и аналитику»: производственные ордера и обработка рыночных данных выполняются полностью на карте, а хост через PCIe Gen3 x16 считывает статус и загружает параметры стратегий и правила риска, сочетая производительность и эксплуатацию.
4. Типичная сквозная архитектура системы
Типовая топология платформы количественной торговли на базе VU13P:
- Ввод рыночных данных: биржевые потоки поступают в FPGA напрямую через оптические порты 100G (QSFP28), 128 пар GTY несут несколько линий;
- Аппаратный разбор: модули Feed Handler декодируют, проверяют и арбитрируют линии A/B по протоколу (ITCH/FAST/MDP3 и др.) в конвейере;
- Стакан заявок и сигналы: Block RAM в кристалле ведёт стаканы заявок для нескольких инструментов, разделы стратегий параллельно вычисляют сигналы, при выполнении условий триггера генерируются ордера;
- Риск и кодирование: ордера проходят предторговые проверки риска и кодируются в сообщения биржевого протокола перед попаданием в буфер передачи;
- Связь с хостом: подтверждения ордеров, отчёты об исполнении и мониторинг состояния отправляются хосту через PCIe Gen3 x16; параметры стратегий и правила риска загружаются с хоста;
- Интерфейсы расширения: FMC+ используется для подключения пользовательских сетевых карт/дочерних ускорительных плат, OCULINK — для межплатных высокоскоростных соединений и масштабирования на несколько плат.
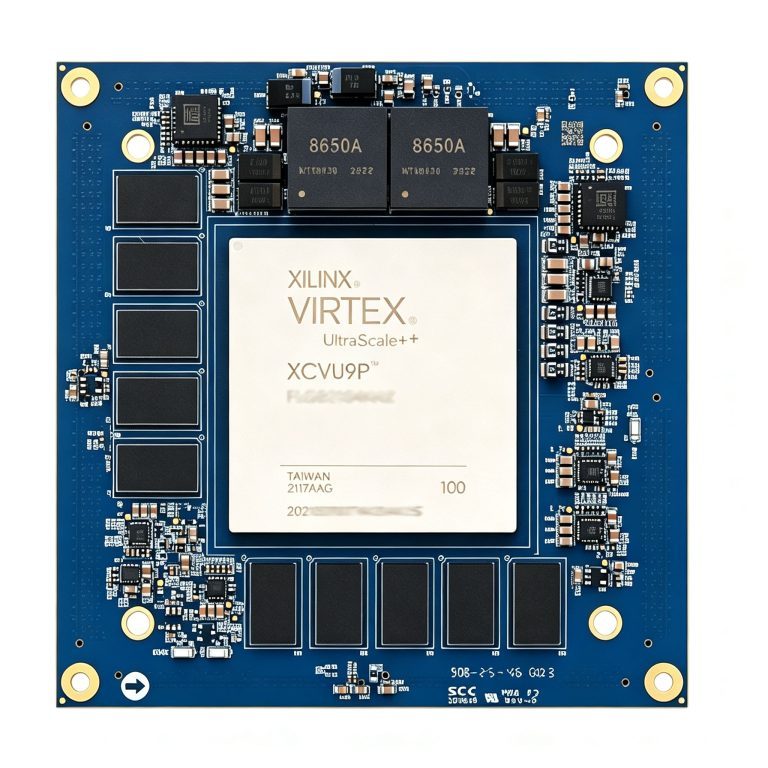
В форме развёртывания плата разработки VU13P может использоваться непосредственно как PCIe-ускорительная карта внутри сервера; для сценариев, чувствительных к пространству стойки и энергопотреблению, на основе этой платформы можно адаптировать форм-фактор платы-ядра с меньшим энергопотреблением.
5. Инженерные преимущества VU13P перед другими подходами
Таблица: сравнительный взгляд на аппаратные платформы количественной торговли
| Параметр | Относительное преимущество VU13P (FPGA) |
|---|---|
| Сквозная задержка | полная цепочка 300 нс – 1 мкс, предварительный триггер 30–100 нс; программные подходы обычно 1–100 мкс |
| Детерминированность задержки | фиксированная глубина конвейера, без джиттера прерываний/планирования, хорошо для риска и аудита |
| Параллельная ёмкость | 3 780K логических ячеек + 12 288 DSP, несколько стратегий/инструментов одновременно |
| Пропускная способность интерфейсов | 128×GTY, несколько оптических портов 100G, PCIe Gen3 x16, прямое подключение к нескольким биржам |
| Гибкость | реконфигурируемость: изменение стратегии — это конфигурация/перезагрузка, без замены платы; цикл разработки намного короче, чем у ASIC |
| Порог разработки | ниже, чем у ASIC; Vitis HLS/OpenCL отображает из C/C++, ключевые пути дополнительно оптимизируются на RTL |
По сравнению с CPU: VU13P на порядок опережает по задержке и детерминированности; по сравнению с GPU: GPU сильны в пакетной пропускной способности, но конвейер и планирование создают джиттер задержки, что делает их непригодными для критических путей наносекундного уровня, тогда как детерминированная задержка VU13P подходит естественным образом; по сравнению с ASIC: ASIC обеспечивает наилучшую производительность, но требует непомерных единовременных затрат и цикла разработки и подходит только для полностью замороженных алгоритмов, тогда как VU13P сохраняет гибкость для эволюции стратегий. Именно поэтому проприетарные торговые фирмы повсеместно используют «FPGA для критического пути, CPU/GPU для исследований и офлайн-вычислений» как стандартное разделение труда.
6. Ключевые моменты разработки и развёртывания
- Разделение инструментов: критические пути (разбор протоколов, кодирование ордеров) используют RTL для гарантии задержки; логику стратегий можно быстро реализовать с помощью Vitis HLS / OpenCL, сначала проверяя поведение в программной симуляции, затем синтезируя в аппаратуру;
- Модульные интерфейсы: Feed Handler, Order Book, Strategy, Risk и Gateway единообразно используют интерфейсы данных AXI-Stream, что упрощает замену, повторное использование и командную работу;
- Тактовые сигналы и синхронизация: при развёртывании на нескольких платах/площадках внедряйте PTP/1PPS и тактовое дерево с низким джиттером для единой временной базы, обеспечивая выравнивание отчётов об исполнении с временными метками рыночных данных;
- Начните со стандартной платы: сначала завершите разбор рыночных данных и проверку стратегии на плате разработки VU13P, прогоните цепочку задержек, затем адаптируйте форм-фактор платы (количество интерфейсов, мощность, конструкция) под требования проекта;
- Мониторинг и регрессия: сохраняйте счётчики статистики и точки наблюдения ILA в аппаратной логике, отслеживайте задержку конвейера на каждом этапе в течение торгового дня — любая деградация быстро локализуется.
7. Ограничения и рекомендации по выбору
FPGA — не ответ для каждого количественного сценария. Если стратегия перебалансируется с горизонтом в минуты или часы или опирается на крупномасштабные признаки машинного обучения с частыми итерациями сложных моделей, преимущества по стоимости и гибкости программного стека CPU/GPU очевиднее; если команде не хватает навыков аппаратной разработки, циклы оценки, отладки и обслуживания проекта FPGA нужно закладывать с запасом. Когда аппаратная низкая задержка подтверждена как требование, выбор устройства можно расслоить по потребностям в ресурсах:
- VU9P: 2 586K логических ячеек, 6 840 DSP, с оптическими портами 2×200G + 4×100G, 32 ГБ DDR4 ECC, PCIe x16 — подходит для сценариев с большим объёмом поступающих рыночных данных и акцентом на хранение/пропускную способность;
- VU13P: 3 780K логических ячеек, 12 288 DSP, 128×GTY — подходит для параллельных мультистратегий, сложной стратегической логики и сценариев, требующих больше ресурсов в кристалле; всесторонняя основная платформа этого класса приложений;
- VU13F: также 12 288 DSP, с 4×FMC+ для обширного расширяемого ввода/вывода и интерфейсов дочерних плат — подходит для системной интеграции, требующей пользовательских сетевых карт, радиочастотных фронт-эндов и другого внешнего оборудования.
Примечание: значения задержки в статье — типичные диапазоны из открытых источников; фактические значения зависят от протоколов, скоростей пакетов, реализации стратегии и разводки платы. Выбор и приёмка должны основываться на измерениях на месте.
8. Заключение
Аппаратизация количественной торговли — это уверенный тренд на протяжении многих лет: от ранней разгрузки сетевых карт до переноса разбора рыночных данных и всей ордерной цепочки на FPGA и до сегодняшнего дня, когда одно устройство класса VU13P одновременно несёт мультирыночные данные, мультистратегии и контроль риска. Ценность VU13P в том, что она объединяет «масштаб» и «скорость» на одном устройстве — достаточно логики и DSP, чтобы сложные комбинации стратегий работали параллельно в аппаратуре, и достаточно GTY и оптических портов 100G, чтобы подключение к нескольким биржам больше не было узким местом. Duyuan Electronics предлагает стандартные платы разработки VU13P/VU9P, пользовательские платы-ядра, IP-пакеты для декодирования рыночных данных и низколатентных цепочек, а также полную техническую поддержку, помогая командам быстро перейти от проверки на оценочной плате к готовой к развёртыванию аппаратной платформе количественной торговли.
Справочные материалы
- AMD, страница продукта Virtex UltraScale+ FPGA (спецификации XCVU13P): https://www.amd.com/en/products/adaptive-socs-and-fpgas/fpga/virtex-ultrascale-plus.html
- AMD/Xilinx совместно с LDA, эталонное решение CME Tick-to-Trade за 25 наносекунд: https://www.xilinx.com/publications/solution-briefs/partner/xilinx-lda-amd-tick-to-trade-solution-brief.pdf
- libfpga, FPGAs in high-frequency trading: the anatomy of a nanosecond (сравнение задержек tick-to-trade): https://libfpga.com/blog/fpgas-for-hft
- semidesignjobs, FPGAs in High-Frequency Trading: A Technical Deep Dive: https://www.semidesignjobs.com/blog/fpga-hft-technical-deep-dive
- Enyx, nxFramework (платформа tick-to-trade менее 100 нс): https://www.enyx.com/nxframework/
- «Компьютерные приложения и программное обеспечение» 2025, проектирование и реализация системы ускорения рыночных данных со сверхнизкой задержкой на основе OpenCL: https://shcas.net/cn/article/doi/10.3969/j.issn.1000-386x.2025.03.003
- ACM, DSL Programmable Engine for High Frequency Trading Acceleration (ускорение протокола FAST): https://dl.acm.org/doi/pdf/10.1145/2088256.2088268
Duyuan Electronics · Прикладная практика | Данные по состоянию на сентябрь 2026 г.; границы определения у разных организаций различаются, все источники аннотированы