Медицинская ультразвуковая фокусировка: сигнальная цепь на 128 каналов и бюджет скорости данных
Цветной УЗИ-зонд на 128 каналов оцифровывает каждый канал 12-битным АЦП на 40 Мвыб/с, и исходная скорость данных составляет около 7,7 ГБ/с — такой объём процессор не примет, не то что построит изображение в реальном времени. Правильный путь: формирование луча, детекция огибающей и прореживание выполнить сначала внутри FPGA, а хосту отдать лишь сжатые данные изображения. В этой статье цепь из 128 каналов разбирается по этапам, считается бюджет скорости данных на каждом шаге и объясняется, что именно делает FPGA между ними.
1. Полная сигнальная цепь УЗИ-визуализации
От массива датчиков до полутонового изображения на экране сигнал проходит длинную цепь, а FPGA стоит после аналогового фронтенда и перед формированием изображения на хосте:
1. Массив датчиков (128 элементов): излучает ультразвук и принимает эхо тканей; каждый элемент — отдельный канал.
2. Аналоговый фронтенд (AFE): TGC-компенсация усиления по времени → полосовой фильтр → переменное усиление → оцифровка АЦП.
3. Формирование луча в FPGA: программно управляемая задержка, взвешивание и суммирование по каждому каналу в строку развёртки, динамическая фокусировка.
4. IQ-демодуляция + прореживание + детекция огибающей: сжатие высокочастотного RF-сигнала в полутоновые данные амплитуды.
5. Преобразование развёртки + кадровый буфер + загрузка по PCIe: перевод полярных строк в декартовы координаты и передача хосту на DSC и цветовое отображение.
Шаги 3 и 4 должны идти в FPGA по прямой причине: 128 каналов нужно выровнять, задержать и взвешенно просуммировать за микросекунды, причём каждая задержка динамически меняется с глубиной. Это высокопараллельная, поКанальная, детерминированная по времени работа; программному обеспечению на универсальном CPU не хватает ни параллелизма, ни реальной частоты кадров.
2. Бюджет скорости данных на 128 каналов (сначала посчитай, потом подключай)
Бюджет начинается с одиночного канала АЦП и умножается вверх. Возьмём 12-битный АЦП 40 Мвыб/с:
| Этап | На канал | Всего 128 каналов | Примечание |
|---|---|---|---|
| Исходная выборка АЦП | 12 бит × 40 Мвыб/с = 480 Мбит/с (60 МБ/с) | 128 × 480 = 61440 Мбит/с ≈ 61,4 Гбит/с (7,68 ГБ/с) | Пиковый поток на входе FPGA |
| Формирование луча (сумма с задержкой) | 128 каналов взвешенно → 1 строка | После суммы уже не 128 параллельных путей | Параллелизм сжимается здесь |
| IQ-демод + CIC/FIR прореживание | RF 40 Мвыб/с → эквивалент ~10 Мвыб/с комплексно | Один путь ~20 МБ/с (комплексно 12 бит) | После децимации ниже 1/4 исходной |
| Детекция огибающей + лог-сжатие | 8 бит амплитуды, ~10 Мвыб/с | Один путь ~10 МБ/с | Динамический диапазон сжат до 40–60 дБ |
| Загрузка по PCIe на хост | — | 256 строк × 60 к/с × 8 бит ≈ 122 МБ/с | CPU обрабатывает только этот уровень |
Главный вывод: сжатие происходит внутри FPGA. В FPGA входит параллельный поток 61,4 Гбит/с, а наружу к хосту выходит лишь около 122 МБ/с полутоновых кадров. Коэффициент сжатия превышает 60× — его даёт формирование луча, объединяющее 128 путей в один, а затем прореживание и детекция, сворачивающие высокочастотный RF в огибающую амплитуды. Пропустить FPGA и отдать исходный поток 7,68 ГБ/с на CPU не выдержат ни пропускная способность памяти, ни PCIe.
Частота кадров и число строк развёртки
При формировании луча каждая строка требует новой задержанной суммы по 128 каналам. Пусть кадр содержит N строк при частоте F; FPGA должен выполнить N×F суммирований в секунду. При N=256 и F=60 к/с это 256 × 60 = 15360 строк в секунду, каждая суммирует 128 взвешенных задержанных отсчётов — отправная точка для оценки множителей FPGA (DSP) и внутристрочной RAM (FIFO линий задержки).
3. Как разделена внутренняя цепь FPGA
1. Синхронный захват и выравнивание каналов
128 каналов обычно разнесены по нескольким AFE и входят в FPGA по JESD204B или параллельному LVDS. Первый барьер — компенсация перекоса (skew): длины дорожек у каналов разные, поэтому отсчёты до FIFO нужно выровнять по одному опорному такту; иначе суммирование с задержкой даст фазовое рассогласование, боковые лепестки и призраки.
2. Динамическая фокусировка, сумма с задержкой (Delayed-and-Sum)
Каждый элемент находится на разном расстоянии до точки фокуса, поэтому эхо приходит в разное время. FPGA компенсирует эту разницу программно управляемыми линиями задержки (FIFO с настраиваемой глубиной или тапированные задержки) по каждому каналу, затем умножает на вес аподизации и суммирует. Глубина фокуса движется с временным окном, поэтому параметры задержки обновляются по сегментам; это расходует много BRAM и DSP на умножение-накопление.
3. IQ-демодуляция, прореживание и детекция огибающей
Суммированная RF-строка сначала проходит квадратурную демодуляцию (смешивание I/Q), затем каскад CIC + FIR прореживает частоту выборки; преобразование Гильберта находит огибающую, лог-сжатие отображает большой динамический диапазон в 8-битные полутона. Этот этап — типовая конвейерная фильтрация: высокая загрузка DSP, но низкий параллелизм.
4. Преобразование развёртки, кадровый буфер и загрузка
Полярные веерные строки ресемплируются в декартовые прямоугольные пиксели, пишутся в кадровый буфер DDR3/4, затем DMA передаёт весь кадр по PCIe хосту. Этот этап зависит от пропускной способности DDR и DMA-движка, а не от пропускной способности DSP.
4. Практический пример: выбор фронтенда портативного цветного УЗИ
Портативный цветной УЗИ-фронтенд использует 128-канальный AFE, RF-выборка 40 Мвыб/с, 12 бит. Формирование луча должно параллельно обрабатывать 128 линий задержки и взвешенные умножения, плюс канал допплеровского потока крови. По бюджету выше исходные 61,4 Гбит/с сжимаются внутри FPGA до ~122 МБ/с полутоновых кадров; чистая пропускная способность PCIe Gen2 x4 переносит это с запасом.
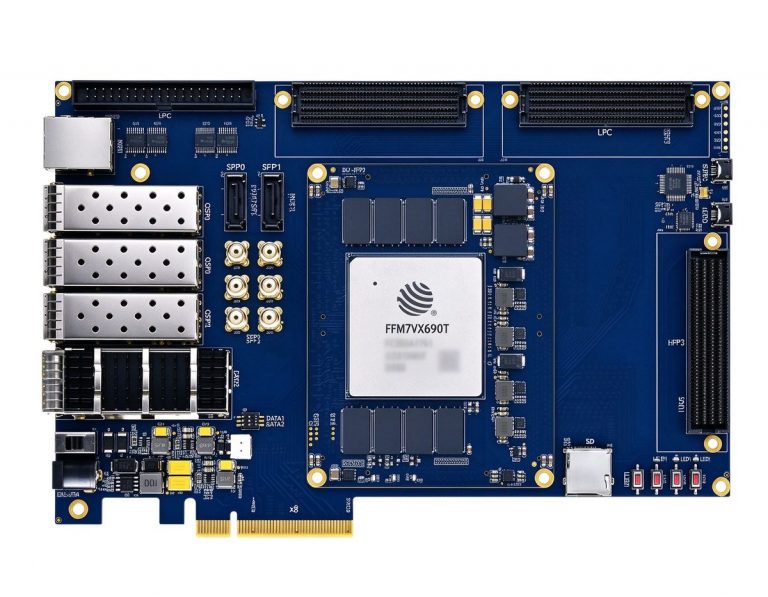
- Большая ёмкость (DUF7690T / JFM7VX690T): достаточно логики и внутристрочной RAM, чтобы одновременно держать 128 FIFO линий задержки, синтез полутонов и допплеровский канал; для полного комплекта 128 каналов при высокой частоте кадров.
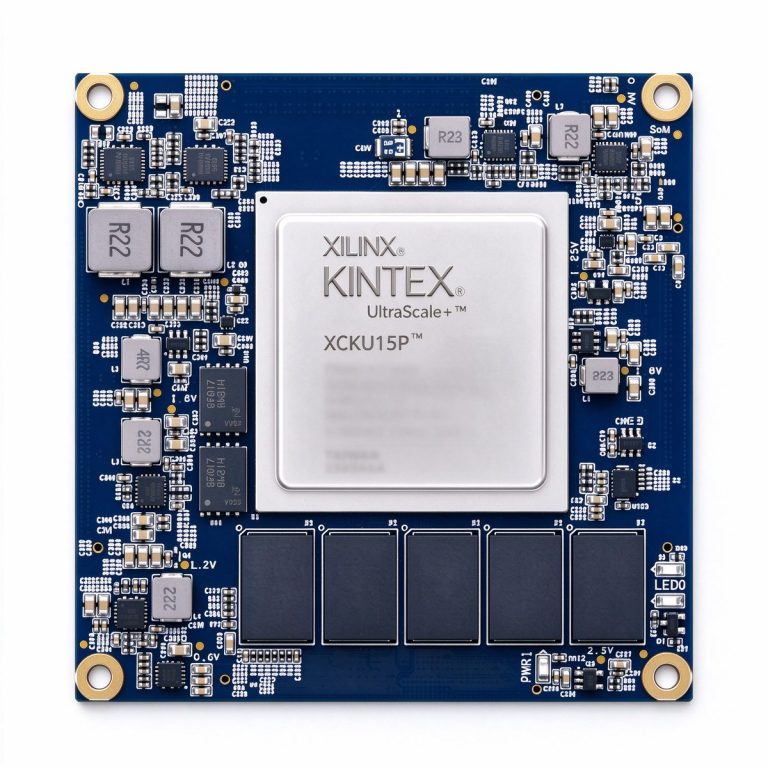
- Расширение каналов (XCKU15P): сильные трансиверы и агрегация многоканального LVDS; для дальнейшего расширения каналов или распределённых зондов, передающих данные AFE по оптоволокну.
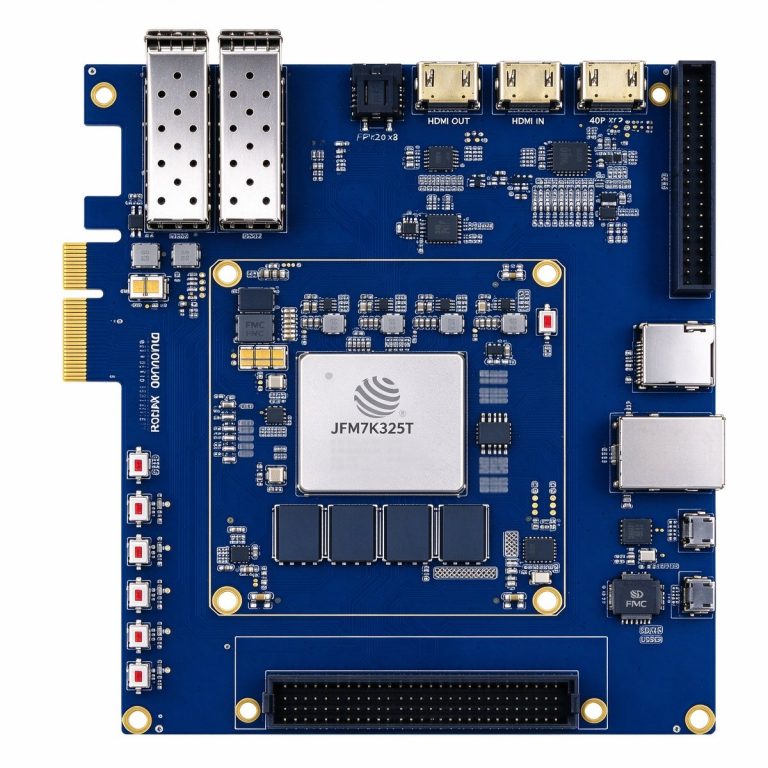
- Средний входной уровень (DUK7325T / JFM7K325T): сбалансированные ресурсы и цена; для прототипирования 64–128 каналов полутонов и средне-низовых продуктов — здесь отработать сумму с задержкой и детекцию, затем переходить на ёмкостную платформу.
Суть УЗИ-визуализации — параллельной суммой с задержкой внутри FPGA «посчитать» 128 высокоскоростных исходных эхо в одну строку развёртки. Когда бюджет скорости ясен — 61,4 Гбит/с на фронтенде, 122 МБ/s на загрузке — понимаешь, какой шаг обязан остаться на кристалле, а какой можно отдать хосту. В медицинском УЗИ FPGA — не плата ускорителя, а само формирование изображения.