Промышленное зрение в реальном времени на FPGA: от GigE-камеры до калибровки дефектов
На линии контроля дефектов, от пикселей камеры до сигнала отбраковки, где именно FPGA незаменим? В этой статье сначала подсчитан бюджет пропускной способности всего потока данных, затем разобраны четыре роли FPGA в тракте технического зрения, сопоставлены границы реального времени классических алгоритмов и глубокого обучения, а на примере реальной AOI-станции контроля паяных соединений печатных плат показан воспроизводимый выбор оборудования.
1. Сначала счёт по полосе: поток данных линии 1080p60
Первое препятствие промышленного зрения—не алгоритмы, а полоса. Возьмём самый обычный тракт—одну камеру 1080p, 60 кадр/с стандарта GigE Vision—и посчитаем её скорость потока:
| Формат вывода | Расчёт | Результат | Потянет гигабитный линк? |
|---|---|---|---|
| 8-бит Bayer (наиболее частый) | 1920 × 1080 × 8 бит × 60 | ≈ 995 Мб/с ≈ 124 МБ/с | Занимает 99,5 % 1 Гбит/с, впритык |
| 12-бит Bayer (HDR/слабый свет) | 1920 × 1080 × 12 бит × 60 | ≈ 1,49 Гб/с ≈ 187 МБ/с | Выше гигабита; нужны 2,5G/10G или CoaXPress |
| 4 × 8-бит камеры | 995 Мб/с × 4 | ≈ 4 Гб/с ≈ 500 МБ/с | Нужны 4× гигабитная агрегация или 10G-восходящий канал |
Если передавать эти исходные кадры целиком на CPU или GPU, каждый канал прокачивает 124–187 МБ/с; четыре канала—500 МБ/с. На стороне CPU кадр ещё нужно обработать целиком—полоса и вычисления горят с обоих концов. А контролю дефектов нужно лишь: где аномалия, какой тип, какие координаты—часто это несколько сотен байт.
Ключевое: где обрабатываются пиксели—определяет стоимость всего тракта
Переносить кадры куда-то и обрабатывать потом—подход «носильщика»; обрабатывать пиксели на месте, пока они текут—подход «конвейера». Первый добавляет полный канал полосы и вычислений на каждую камеру; второй—только логику обработки.
2. Четыре роли FPGA в тракте технического зрения
Роль 1. Подключение и синхронизация нескольких камер
Декодирование протоколов GigE Vision / CoaXPress, конфигурирование камер и управление триггером берёт на себя MAC-слой и триггерная логика прямо в FPGA. Несколько камер запираются на одном аппаратном такте триггера, обеспечивая экспозицию с разных ракурсов в один и тот же момент—то, что программно достичь детерминированно крайне трудно.
Роль 2. Предобработка изображения (шумоподавление, усиление, интерполяция Байера)
Шумоподавление, баланс белого, усиление, интерполяция Байера, извлечение ROI—всё это попиксельные операции. Конвейер FPGA естественным образом выдаёт один пиксель за такт; тактовая частота пикселей при 1080p60 около 148,5 МГц—далеко в запасе по таймингу таких кристаллов, как JFM7K410T. Та же попиксельная работа на CPU—цикл в несколько–десятки миллисекунд на кадр; на FPGA—фиксированная задержка в несколько десятков тактов.
Роль 3. Контроль дефектов (шаблон, разность, связные компоненты)
Шаблонное сопоставление, вычитание кадров, пороговая сегментация, анализ связных компонентов, морфологическая обработка—всё параллельно, всё конвейеризуется. Шаблонное сопоставление на изображении 1080p на FPGA выполняется менее 1 мс на кадр, задержка не зависит от частоты кадров и полностью детерминирована—жёсткое требование к такту линии.
Роль 4. Выдача результата и сопряжение с IO
Вердикт напрямую управляет механизмом отбраковки, сигнальной лампой, счётчиками. Задержка GPIO-выхода FPGA—наносекундного уровня, без задержек через ОС, драйвер и прикладной уровень. В момент, когда появился дефект, сигнал отбраковки уже дошёл до исполнительного механизма.
3. Два алгоритмических пути: классическое зрение vs глубокое обучение
«Давайте добавим глубокое обучение»—мантра последних лет, но границу реального времени между двумя путями надо проводить честно:
| Измерение | Классическое зрение (шаблон/разность/морфология) | Глубокое обучение (CNN/YOLO-класс) |
|---|---|---|
| Задержка кадра 1080p | <1 мс (конвейер FPGA) | 2–10 мс (GPU) или выше (универсальный NPU) |
| Ресурсы | Немного LUT/DSP | Много DSP + полоса внешней памяти |
| Интерпретируемость | Пороги настраиваемы, дефекты трассируемы | Чёрный ящик, ложные срабатывания локализовать трудно |
| Область применения | Фиксированные шаблоны дефектов, быстрые линии | Сложные дефекты, офлайн-повторная проверка |
| На FPGA | Зрело, высокая инженерная проработка | Нужны квантование/прореживание, обычно на CPU/GPU |
Мейнстрим-архитектура линии 2026 года—предобработка на FPGA + классический вердикт в реальном времени + офлайн-повторная проверка глубоким обучением: FPGA гарантирует вердикт и отбраковку внутри такта, глубокое обучение делает вторую проверку подозрительных участков—каждый занимается своим делом.
4. Реальный случай: AOI-станция контроля паяных соединений
Инженерный случай · 01: контроль паяных соединений на SMT-линии—60 кадр/с, ложные срабатывания < 0,5 %
AOI-станция на SMT-линии должна выявлять холодную пайку, мосты и отсутствие компонентов, работать непрерывно на 60 кадр/с, целевой уровень ложных срабатываний < 0,5 %, пропуск холодной пайки < 1 %.
- Камеры: 2 × GigE-20-Мп промышленные камеры, реально кроп по ROI 1080p, вывод 8-бит Bayer
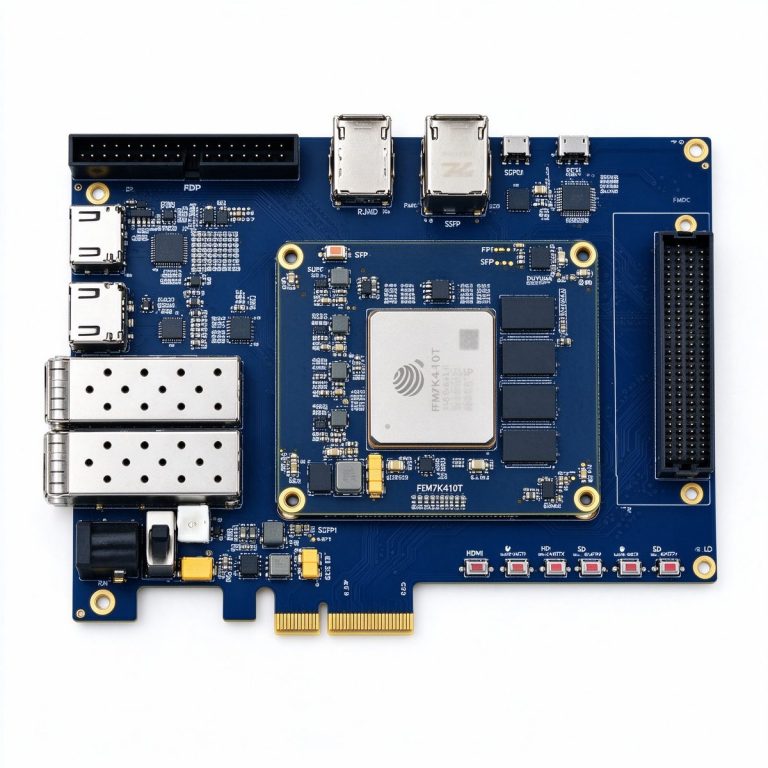
- Плата: DUK7410T (Fudan Micro JFM7K410T, 406K логических ячеек, FMC HPC, 4 ГБ DDR3)
- Поток данных: 2 × 995 Мб/с ≈ 2,5 Гб/с в FPGA → буфер кадров DDR → вычитание по шаблону + анализ связных компонентов → вывод вердикта
Измеренные результаты: обработка кадра < 0,8 мс; сквозная задержка от триггера камеры до сигнала отбраковки < 1,5 мс; ложные срабатывания < 0,5 %, выявляемость холодной пайки > 99 %.
В сравнении с CPU: сквозная задержка упала с ~15 мс до < 1,5 мс, загрузка CPU хоста с 85 % до 5 %—исходный программный конвейер давал только 30 кадр/с; после перехода на FPGA производительность удвоилась.
Ключ этой станции—не хитрый алгоритм, а то, что действие контроля успевает за тактом линии. В момент, когда пришёл кадр с дефектом, вердикт и отбраковка должны завершиться до следующего кадра.
5. Как выбрать железо: три платы, три стратегии
Выбор идёт по трём вопросам: сколько камер? насколько жёсткие требования к задержке? какой бюджет машины?—три типовые платформы Duyuante:
DUK7410T (¥9 999)—серединный рабочий конь, стандарт для AOI на 1/2 камеры
Fudan Micro JFM7K410T, 406K логических ячеек, 1 540 DSP, FMC HPC, HDMI 4K-вход, 2× SFP+. FMC HPC напрямую подключается к высокоскоростным камерам или ADC-мезонинам, HDMI 4K-вход может одновременно работать как петля отображения. Визуальное позиционирование, контроль дефектов, прототипы многоканальной сшивки—большинство проектов начинаются с этой платы.
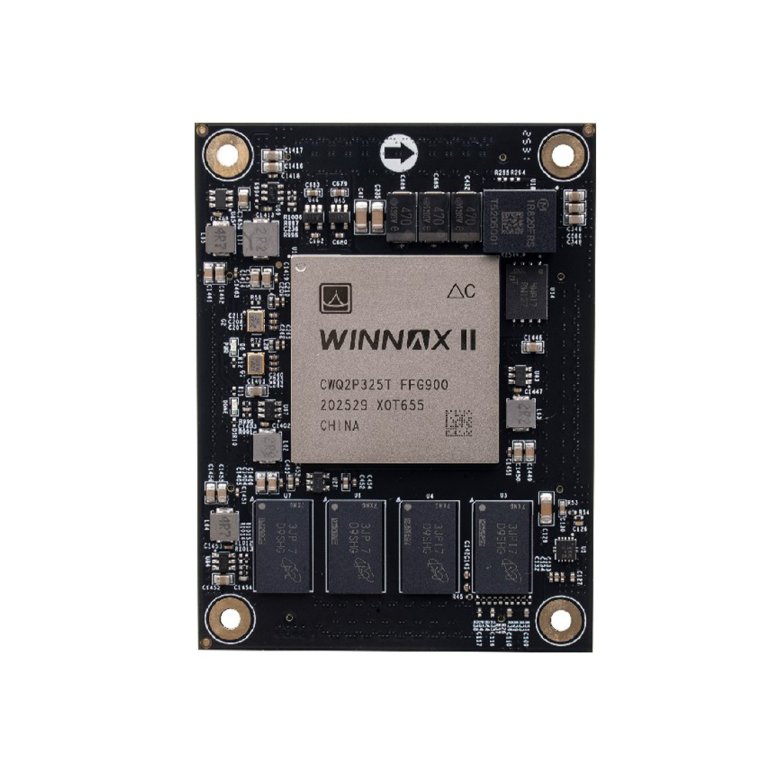
PBC7K325G (¥1 999)—встраивание в машину при ограниченном бюджете
SoM архитектуры China Kintex-7, 326K логики, 16 трансиверов GTX, 2 ГБ DDR3, промышленный диапазон −40…85 °C. Однокамерный встроенный контроль с фиксированным шаблоном дефектов или объединённые контроллеры «зрение + движение». Продукты с ограниченным бюджетом берутся отсюда.
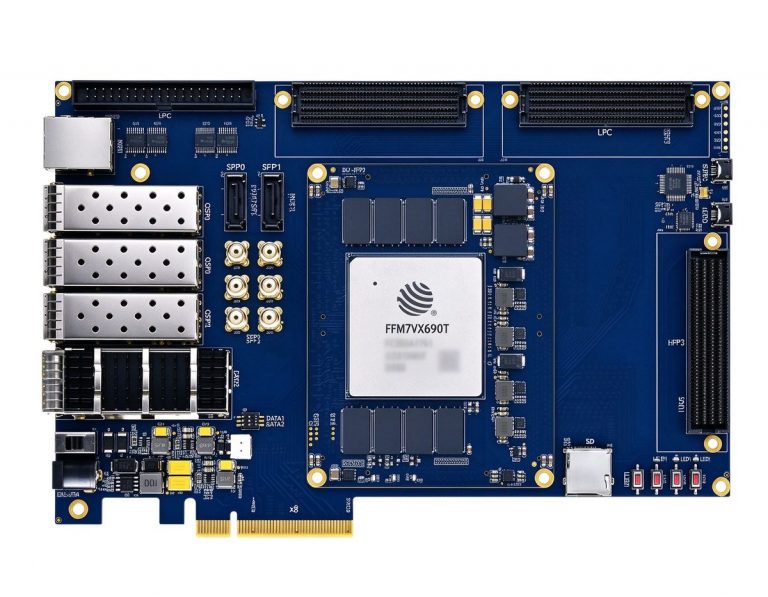
DUF7690T (¥24 999)—многокамерные массивы и высокопроизводительные композитные системы
Fudan Micro JFM7VX690T, 693K логических ячеек, 3 600 DSP, 36 пар GTH, QSFP 40G. Массивы от 8 камер, 8K-сшивка или композитные системы «зрение + оптоволоконная связь»—когда нужны большая логика и большая полоса, поднимаются на эту плату.
Первый принцип промышленного зрения: «не таскайте целые кадры туда-сюда»—обрабатывайте пиксели там, где они текут, и проблемы задержки, полосы и мощности исчезают разом.
>
— Инженерная команда Duyuante