Планирование пропускной способности PCIe: сколько чистой полосы реально дают Gen3 x4 – x16
Счёт по полосе PCIe сложнее, чем цифра в даташите—теоретическая полоса, кодирование, накладные расходы протокола, эффективность DMA и узкое место DDR съедают обещанные «16 ГБ/с». В статье разбираются Gen3 x4/x8/x16 вплоть до согласования с DDR и DMA и даётся повторяемая методика оценки чистой полосы.
1. Три уровня полосы: теоретическая, после кодирования, чистая
Видя в спецификации «PCIe Gen3 x16», вы интуитивно ждёте 16 ГБ/с. Эта цифра на самом деле—сырая скорость в битах, а не та полоса, которой можно пользоваться. Между ними два уровня потерь:
| Уровень | Расчёт для Gen3 x16 | Результат | Смысл |
|---|---|---|---|
| ① Сырая скорость | 16 линий × 8,0 GT/s | 128 Гб/с | Исходная скорость символов на линке |
| ② Полоса после кодирования | 128 × 128/130 (Gen3 использует 128b/130b) | ≈ 126 Гб/с ≈ 15,75 ГБ/с | Скорость полезной нагрузки после кодирования |
| ③ Фактическая чистая полоса | 15,75 × КПД (80–90%) | ≈ 12,6 – 14,2 ГБ/с | Реально доступная полоса после заголовков TLP, дескрипторов DMA и прерываний |
Gen3 работает на 8,0 GT/s на линию и имеет всего 1,5 % накладных расходов кодирования 128b/130b—в этом ключ эффективности по сравнению с Gen2 (20 % на 8b/10b). Сравнение по ширинам:
| Ширина PCIe | Сырая скорость | Полоса после кодирования | Типичная чистая полоса (блочный DMA) |
|---|---|---|---|
| Gen3 x4 | 32 Гб/с | ≈ 3,94 ГБ/с | ≈ 3,2 – 3,5 ГБ/с |
| Gen3 x8 | 64 Гб/с | ≈ 7,88 ГБ/с | ≈ 6,3 – 7,1 ГБ/с |
| Gen3 x16 | 128 Гб/с | ≈ 15,75 ГБ/с | ≈ 12,6 – 14,2 ГБ/с |
| Gen2 x8 (для сравнения) | 40 Гб/с | ≈ 4,0 ГБ/с (8b/10b) | ≈ 3,2 – 3,6 ГБ/с |
2. Сколько съедает протокол: TLP, payload, чтение против записи
Полоса после кодирования—не чистая полоса. Каждый пакет Transaction Layer Packet (TLP) PCIe несёт заголовок 12–20 байт; чем больше payload, тем меньше доля заголовка и выше КПД.
Размер payload напрямую определяет эффективность
| Размер payload | Доля заголовка TLP | КПД передачи | Типичный сценарий |
|---|---|---|---|
| 4 КБ (макс) | ≈ 0,4 % | ≈ 90 %+ | Большой непрерывный DMA-сбор, видеопотоки |
| 512 Б | ≈ 3 % | ≈ 85–88 % | Обычная обратная передача данных |
| 64 Б | ≈ 25 % | ≈ 55–65 % | Чтение/запись регистров, управление малыми пакетами |
Чтение медленнее записи: скрытая цена Completion
Запись по PCIe—fire-and-forget, отправитель не ждёт подтверждения. Чтение должно дождаться Completion TLP—туда-обратно, что удваивает задержку и сжигает полосу. Замеры:
- Большая последовательная запись: 88–92 % полосы после кодирования
- Большое последовательное чтение: обычно лишь 80–85 % (очередь Completion, накладные расходы)
- Смешанное чтение/запись: переключение направлений вызывает паузы линка, КПД падает ещё на 5–10 %
В инженерном планировании используйте консервативную оценку «чистая полоса = после кодирования × 80 %», а не идеальные 90 %+.
3. DDR—настоящий потолок
Быстрый линк PCIe не значит, что система может выжать максимум—данные в и из FPGA проходят через DDR, и полоса DDR часто первая стена, в которую вы упираетесь.
Как считать полосу DDR
Полоса DDR = ширина шины данных × скорость / 8. На примере типовых плат Duyuante:
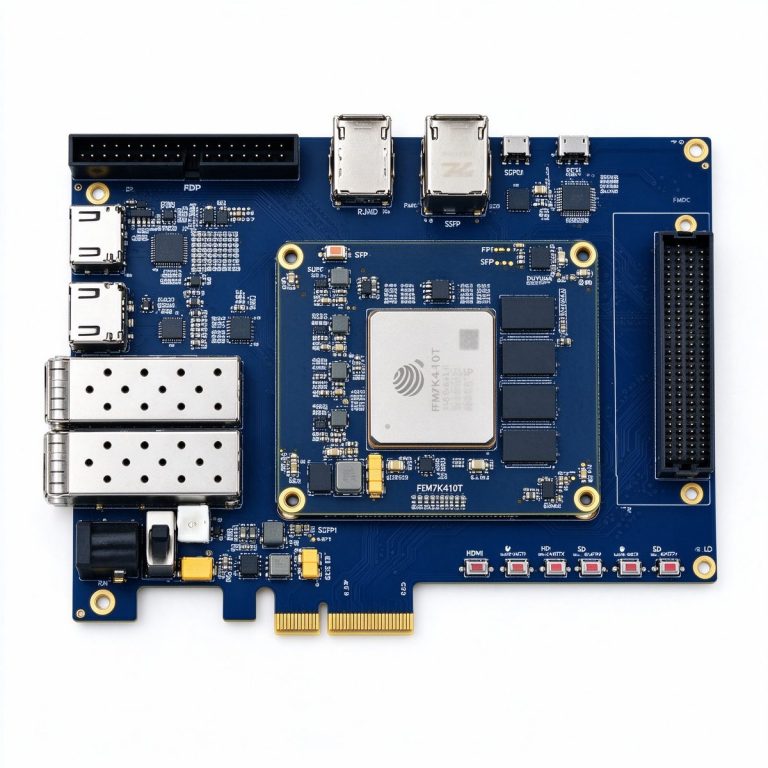
- DUK7410T: 4 ГБ DDR3, 64-bit, 1866 Мбит/с → 64 × 1866 / 8 ≈ 14,9 ГБ/с
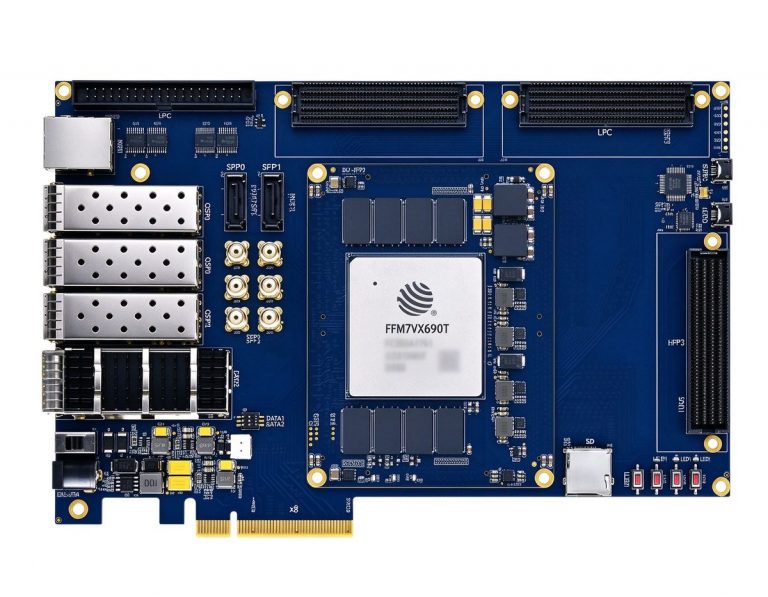
- DUF7690T: 4 ГБ DDR3, 64-bit, 1866 Мбит/с → ≈ 14,9 ГБ/с
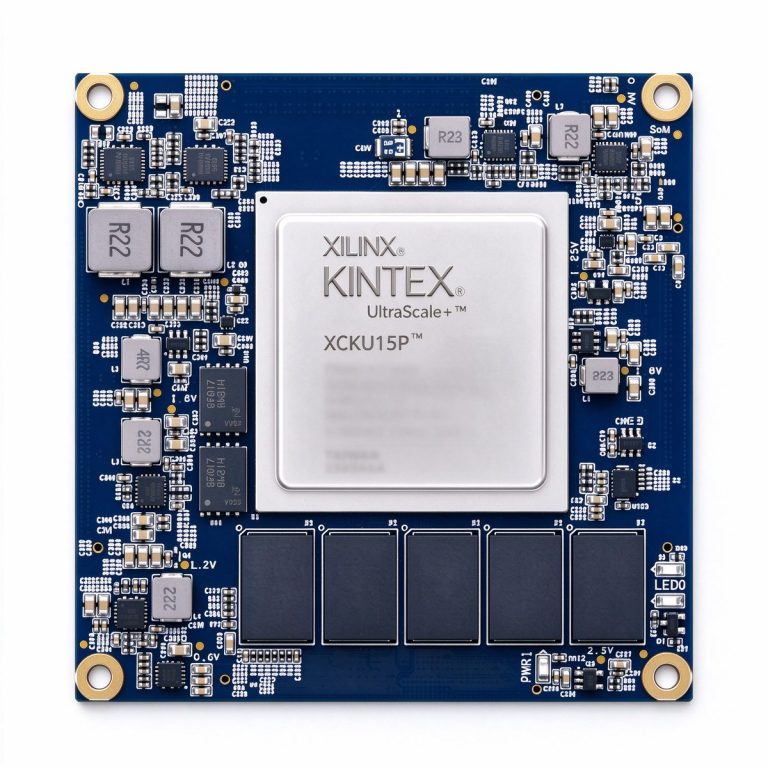
- DUKU15P: 8 ГБ DDR4 ECC, 64-bit (+8-bit ECC) → при 2400 MT/s ≈ 19,2 ГБ/с
Поток двунаправленный: чтение + запись удваивают нагрузку
Представьте высокоскоростной сбор: данные АЦП обрабатываются FPGA и записываются обратно в хост по PCIe. Этот путь проходит через DDR дважды:
- FPGA принимает данные → запись в DDR (буфер кадров)
- FPGA завершил обработку → чтение из DDR (выборка для передачи)
- Полная нагрузка на DDR = полоса записи + полоса чтения
Если PCIe x8 Gen3 даёт 7 ГБ/с чистыми, DDR должен одновременно писать 7 ГБ/с и читать 7 ГБ/с = 14 ГБ/с—вплотную к физическому пределу DDR3 14,9 ГБ/с, почти без запаса под алгоритмы FPGA. Вот почему x8 Gen3 в паре с DDR3—«золотая комбинация», а x16 требует DDR4.
| Плата | Спецификация PCIe | Полоса после кодирования | Конфигурация DDR | Полоса DDR | Вердикт |
|---|---|---|---|---|---|
| DUK7410T | Gen2 x8 | ≈ 4,0 ГБ/с | 4 ГБ DDR3 64-bit | ≈ 14,9 ГБ/с | Узкое место—PCIe, у DDR запас |
| DUF7690T | Gen3 x8 | ≈ 7,88 ГБ/с | 4 ГБ DDR3 64-bit | ≈ 14,9 ГБ/с | ~7,5 ГБ/с в каждую сторону, баланс |
| DUKU15P | Gen3 x16 | ≈ 15,75 ГБ/с | 8 ГБ DDR4 64-bit | ≈ 19,2 ГБ/с | DDR близок к пределу при полной загрузке PCIe |
4. Трёхшаговая оценка: сколько полосы нужно вашему проекту?
Методика · 01: оценка полосы PCIe в три шага
Шаг 1: чистая потребность. Сложите сырые скорости всех источников—минимум, который надо переместить.
Шаг 2: коэффициент запаса. Умножьте на 1,2–1,5 (накладные расходы, всплески, дуплекс).
Шаг 3: обратный пересчёт ширины PCIe. Выберите спецификацию, где полоса после кодирования ≥ потребности с запасом, затем проверьте DDR.
Проверка на трёх типовых сценариях:
| Сценарий | Сырая скорость | Потребность с запасом | Рекомендуемый PCIe | Обоснование |
|---|---|---|---|---|
| Высокоскоростной сбор (2ch × 250 МСП × 14 бит) | ≈ 875 МБ/с | ≈ 1,1 – 1,3 ГБ/с | Gen3 x4 (3,94 ГБ/с) | Запаса достаточно, DDR без напряжения |
| Захват и обработка 4K60 (10 бит 4:2:2) | ≈ 1,5 ГБ/с | ≈ 1,8 – 2,3 ГБ/с | Gen3 x8 (7,88 ГБ/с) | Место под многоканальное видео или сшивку |
| Пакетная передача feature-map ИИ / 8K-видео | ≈ 10 – 12 ГБ/с | ≈ 12 – 18 ГБ/с | Gen3 x16 (15,75 ГБ/с) | Нужен DDR4, иначе DDR упрётся первым |
Правило большого пальца: при выборе ширины PCIe отталкивайтесь от «чистая потребность × 2» и закладывайте двойной запас. Полосу можно нарастить, ширину—только заменой платы.
5. Три платформы PCIe от Duyuante: как выбрать
DUK7410T (¥9 999)—экономичный сбор и обработка
Fudan Micro JFM7K410T, аппаратный блок PCIe Gen2 x8, около 4 ГБ/с после кодирования. С мецонинами FMC HPC для высокоскоростного АЦП-сбора или HDMI 4K-обработки видео—стартуйте отсюда, когда PCIe не узкое место.
DUF7690T (¥24 999)—основной сбор и композитная обработка
Fudan Micro JFM7VX690T, аппаратный блок PCIe Gen3 x8, около 7,88 ГБ/с после кодирования. С 4 ГБ DDR3 и ~7,5 ГБ/с в каждую сторону—в точности под полную x8. Основная платформа для многоканального сбора, обработки радиосигналов и сшивки видео.
DUKU15P (¥15 999)—премиальная обратная передача и 100G-связность
AMD Kintex UltraScale+ XCKU15P, аппаратный блок PCIe Gen3 x16, 15,75 ГБ/с после кодирования, с 8 ГБ DDR4 ECC. Интегрирует 56 высокоскоростных трансиверов (24× GTY 28G + 32× GTH 16G) и 4× 100G Ethernet—флагман для большой полосы PCIe плюс высокоскоростная сеть.
Полоса PCIe—никогда не «скорость интерфейса», а самая короткая доска из «интерфейс × память × DMA». Сначала считайте запас DDR, потом говорите о скорости PCIe.
>
— Инженерная команда Duyuante